İçindekiler
Büyük bir sayı dizisini hem az yer kaplayacak biçimde saklamak hem de üzerinde hızlı sorgular çalıştırmak kulağa iki ayrı hedef gibi gelir. Wavelet ağacı, bu hedefleri aynı veri yapısında buluşturur. Özellikle metin indeksleme, genom analizi, coğrafi veriler ve analitik sistemlerde; bir aralıktaki k’ıncı küçük elemanı ya da belirli bir değerin kaç kez geçtiğini etkileyici hızlarda bulabilir.
``
Temel fikir: Değerleri bitlerle ayırmak
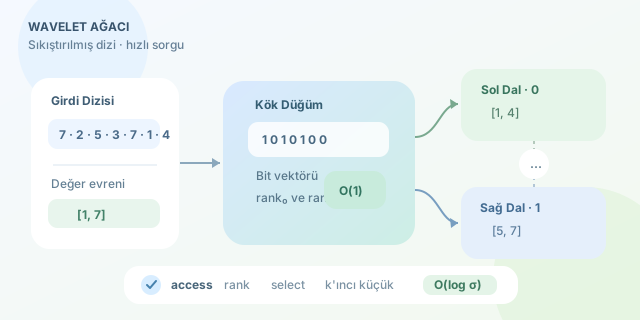
Elimizde $A = [7, 2, 5, 3, 7, 1, 4]$ dizisi olsun. Değerlerin $[1,7]$ aralığında bulunduğunu düşünelim. Wavelet ağacının kökü, değer evrenini yaklaşık olarak ikiye böler:
- Sol çocuk: $[1,4]$
- Sağ çocuk: $[5,7]$
Dizideki her eleman için hangi tarafa gittiğini belirten bir bit yazılır. Sol için 0, sağ için 1 kullanırsak kökün bit dizisi şöyledir:
A:    7 2 5 3 7 1 4
Bit:  1 0 1 0 1 0 0
Ardından elemanlar sıraları korunarak ilgili çocuklara aktarılır. Aynı işlem değer aralıkları tek elemana inene kadar tekrarlanır. Böylece ağacın yüksekliği, alfabe büyüklüğü $\sigma$ olmak üzere yaklaşık
\[h = \lceil \log_2 \sigma \rceil\]olur. Buradaki “alfabe”, yalnızca karakterleri değil dizide bulunabilecek farklı değerleri ifade eder.
Sihirli araç: rank işlemi
Her düğümdeki bit dizisi, rank sorgularını destekleyecek şekilde saklanır. $rank_b(B,i)$, $B$ bit dizisinin ilk $i$ konumunda kaç adet $b$ biti bulunduğunu verir.
Örneğin 1010110 için $rank_1(B,5)=3$ sonucudur. Bir sorgu sırasında mevcut aralığın çocuk düğümdeki karşılığını bu işlemle hesaplarız. Dolayısıyla bütün diziye yeniden bakmak gerekmez.
| Sorgu | Amaç | Karmaşıklık |
|---|---|---|
access(i) |
$i$ konumundaki değeri bulmak | $O(\log \sigma)$ |
rank(x,i) |
İlk $i$ konumda $x$ sayısını bulmak | $O(\log \sigma)$ |
select(x,k) |
$x$ değerinin $k$’ıncı geçişini bulmak | $O(\log \sigma)$ |
kth(l,r,k) |
Aralıktaki $k$’ıncı küçük değeri bulmak | $O(\log \sigma)$ |
Aralıktaki k’ıncı küçük eleman
kth(l, r, k) sorgusunda kökteki $[l,r]$ bölümünde kaç elemanın sola gittiğini hesaplarız. Bu sayı
şeklindedir. Eğer $k \le z$ ise aranan eleman sol çocuktadır. Aksi durumda sağ çocuğa geçer ve $k$ değerini $k-z$ yaparız. Her seviyede tek karar verildiği için işlem logaritmik zamanda tamamlanır.
Aşağıdaki Python kodu, aynı fikrin eğitim amaçlı sadeleştirilmiş bir sürümünü gösterir:
class WaveletNode:
    def __init__(self, data, low, high):
        self.low, self.high = low, high
        self.prefix_zero = [0]

        if low == high or not data:
            return

        mid = (low + high) // 2
        left, right = [], []

        for value in data:
            goes_left = value <= mid
            self.prefix_zero.append(
                self.prefix_zero[-1] + int(goes_left)
            )
            (left if goes_left else right).append(value)

        self.left = WaveletNode(left, low, mid)
        self.right = WaveletNode(right, mid + 1, high)

    def kth(self, left, right, k):
        if self.low == self.high:
            return self.low

        before = self.prefix_zero[left]
        zeros = self.prefix_zero[right + 1] - before

        if k <= zeros:
            return self.left.kth(before, before + zeros - 1, k)

        left_ones = left - before
        right_ones = right - self.prefix_zero[right + 1]
        return self.right.kth(left_ones, right_ones, k - zeros)
Burada prefix_zero, sabit zamanda sıfırların rank değerini üretir. Gerçek sıkıştırılmış yapılarda düz önek dizileri yerine succinct bit vector teknikleri kullanılır; aksi hâlde yardımcı diziler bitlerden daha fazla alan tüketebilir.
Neden gerçekten sıkıştırılmıştır?
Klasik wavelet ağacı yaklaşık $n\log_2\sigma$ bit kullanır. Huffman biçimli wavelet ağaçlarında sık değerler daha kısa yollara yerleştirilerek alan, sıfırıncı dereceden entropiye yaklaşabilir:
\[nH_0(A) + o(n\log\sigma)\]Bu nedenle wavelet ağacı yalnızca hızlı değildir; veri dağılımını da avantaja çevirebilir. Kısacası, sıkıştırma ile sorgu performansının kavga etmek zorunda olmadığını gösteren zarif ve oldukça kullanışlı bir veri yapısıdır.
Yorumlar