İçindekiler
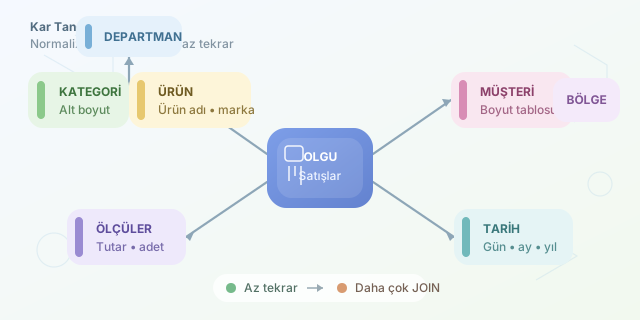
Bir veri ambarında aynı şehir, kategori veya marka bilgisinin binlerce kez tekrarlandığını gördüğünüzde içinizdeki düzen tutkunu geliştirici hemen normalizasyon düğmesine basmak isteyebilir. Kar tanesi şeması, tam olarak bu isteğin veri modeline dönüşmüş hâlidir: Boyut tablolarını alt tablolara ayırarak tekrarı azaltır, bütünlüğü güçlendirir ve karşılığında sorgulara birkaç JOIN daha hediye eder.
``
Kar tanesi şeması nedir?
Kar tanesi şeması, merkezi bir olgu tablosunun çevresindeki boyutların normalize edildiği boyutsal modeldir. Adını, tablolar arasındaki dallanan ilişkilerin kar tanesine benzemesinden alır.
Örneğin bir satış ambarında fact_sales tablosu; ürün, müşteri ve tarih boyutlarına bağlanabilir. Yıldız şemasında ürünün kategorisi ve departmanı doğrudan dim_product içinde tutulurken kar tanesi şemasında bunlar ayrı tablolara çıkarılır:
fact_sales→ satış tutarı ve adet gibi ölçülerdim_product→ ürün adı ve markadim_category→ kategori bilgileridim_department→ kategorinin bağlı olduğu departman
Bu yaklaşım üçüncü normal forma benzer bir mantık izler. Bir bilginin gereksiz kopyaları azaltıldığında güncelleme anomalileri de azalır. Ancak “veri tekrarı sıfıra iner” ifadesini pratikte temkinli yorumlamak gerekir; teknik anahtarlar ve tarihsel kayıtlar yine tekrar edebilir. Amaç, özellikle açıklayıcı boyut niteliklerinin gereksiz tekrarını en aza indirmektir.
Yıldız mı, kar tanesi mi?
| Özellik | Yıldız şeması | Kar tanesi şeması |
|---|---|---|
| Boyut yapısı | Denormalize | Normalize |
| Tablo sayısı | Az | Fazla |
| Sorgu karmaşıklığı | Düşük | Daha yüksek |
| Veri tekrarı | Daha fazla | Daha az |
| Güncelleme bütünlüğü | Yönetimi zorlaşabilir | Daha güçlü |
| BI aracı uyumu | Genellikle kolay | Ek modelleme isteyebilir |
Depolama açısından basit bir tahmin yapalım. Bir kategori adının ortalama uzunluğu $L$ bayt, kategorideki ürün sayısı $N$ olsun. Yıldız şemasındaki yaklaşık tekrar maliyeti:
\[M_{yıldız} \approx N \times L\]Kar tanesi şemasında kategori adı bir kez tutulur; ürünlerde ise genellikle sayısal yabancı anahtar bulunur. Anahtarın boyutu $K$ ise yaklaşık maliyet:
\[M_{kar} \approx L + N \times K\]$L > K$ olduğunda ve $N$ büyüdüğünde depolama avantajı belirginleşir. Yine de modern veri ambarlarında sütun bazlı sıkıştırma, yıldız şemasındaki tekrarın fiziksel maliyetini ciddi ölçüde azaltabilir.
Örnek tablo tasarımı
Aşağıdaki SQL, ürün kategorisini ve departmanı ayrı tablolara taşıyan basitleştirilmiş bir yapı kurar:
CREATE TABLE dim_department (
    department_id INT PRIMARY KEY,
    department_name VARCHAR(100) NOT NULL
);

CREATE TABLE dim_category (
    category_id INT PRIMARY KEY,
    category_name VARCHAR(100) NOT NULL,
    department_id INT NOT NULL,
    FOREIGN KEY (department_id)
        REFERENCES dim_department(department_id)
);

CREATE TABLE dim_product (
    product_id INT PRIMARY KEY,
    product_name VARCHAR(150) NOT NULL,
    category_id INT NOT NULL,
    FOREIGN KEY (category_id)
        REFERENCES dim_category(category_id)
);
Burada departman adı her üründe saklanmaz. Bir departmanın adı değiştiğinde tek satır güncellenir; böylece “Elektronik”, “Elektornik” ve “Elektronik Ürünler” gibi istemeden oluşan varyasyonların önü kesilir.
Sorgular neden uzar?
Bir departmana göre satış toplamını bulmak için olgu tablosundan başlayıp üç boyut seviyesini geçmek gerekir:
SELECT
    d.department_name,
    SUM(f.sales_amount) AS total_sales
FROM fact_sales AS f
JOIN dim_product AS p ON p.product_id = f.product_id
JOIN dim_category AS c ON c.category_id = p.category_id
JOIN dim_department AS d ON d.department_id = c.department_id
GROUP BY d.department_name;
Her ek JOIN, sorgu iyileştiricisine daha fazla iş verir. Büyük tablolarda uygun indeksler, dağıtım anahtarları ve güncel istatistikler yoksa performans düşebilir. Ayrıca analistler tablo ilişkilerini anlamakta zorlanabilir. Bu nedenle semantik katman veya önceden hazırlanmış görünümler kullanmak faydalıdır.
Ne zaman tercih edilmeli?
Kar tanesi şeması; boyut hiyerarşileri derinse, ortak alt boyutlar birçok yerde kullanılıyorsa ve veri bütünlüğü sorgu sadeliğinden daha önemliyse güçlü bir seçenektir. Buna karşılık hızlı raporlama, kullanıcı dostu model ve az sayıda JOIN öncelikliyse yıldız şeması genellikle daha pratiktir.
Kısacası kar tanesi şeması, veri ambarının titiz arşivcisidir: Her şeyi doğru çekmeceye koyar, fakat aradığınız rapora ulaşırken birkaç çekmece daha açmanız gerekir.
Yorumlar