İçindekiler
Bir görüntü modeline milyonlarca kedi, otomobil ve sandalye gösterildiğini; ardından sizin yalnızca birkaç bin tıbbi görüntünüzle hastalık sınıflandırması yapmak istediğinizi düşünün. Modeli sıfırdan eğitmek yerine önceden öğrendiği genel görsel desenleri kullanabilirsiniz. Transfer öğrenme, devasa modellerin biriktirdiği bilgiyi daha küçük ve yerel problemlere taşıyarak zaman, veri ve hesaplama maliyetinden tasarruf sağlar. ``
Transfer öğrenmenin temel fikri
Derin sinir ağlarının ilk katmanları genellikle kenar, renk geçişi, doku veya basit şekil gibi genel özellikleri öğrenir. Daha derindeki katmanlar ise eğitim görevine özgü kavramları temsil eder. Örneğin ImageNet üzerinde eğitilmiş bir modelin erken katmanları çizgileri tanırken son katmanları belirli hayvan ve nesne sınıflarını ayırt eder.
Bir model kabaca iki parçaya ayrılabilir:
\[\hat{y} = g_{\phi}(f_{\theta}(x))\]Burada $f_{\theta}$ özellik çıkarıcı gövdeyi, $g_{\phi}$ ise sınıflandırma başlığını temsil eder. Transfer öğrenmede çoğunlukla $\theta$ parametreleri korunur; yeni probleme göre yalnızca $\phi$ eğitilir. Böylece model, görsel dünyayı yeniden keşfetmek zorunda kalmaz.
Başlıca yaklaşımlar
| Yaklaşım | Eğitilen bölüm | Veri ihtiyacı | Hesaplama maliyeti | Kullanım durumu |
|---|---|---|---|---|
| Özellik çıkarma | Yalnızca son katmanlar | Düşük | Düşük | Küçük veri setleri |
| Kısmi ince ayar | Son bloklar ve başlık | Orta | Orta | Kaynak ve hedef görev benzerse |
| Tam ince ayar | Bütün model | Yüksek | Yüksek | Yeterli veri ve güçlü donanım varsa |
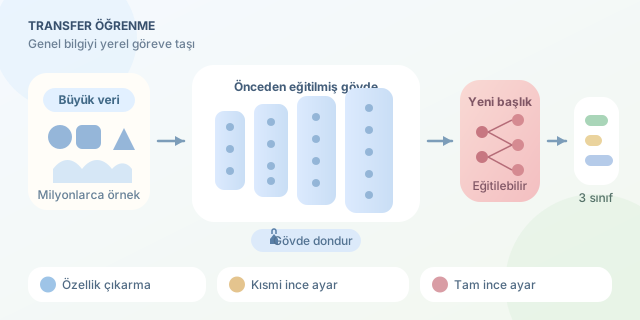
Özellik çıkarma en güvenli başlangıçtır. Model gövdesi dondurulur ve yalnızca yeni sınıflandırıcı eğitilir. Kısmi ince ayarda son birkaç blok açılarak yüksek seviyeli temsiller hedef probleme uyarlanır. Tam ince ayar daha esnektir; ancak küçük veri setlerinde aşırı öğrenme ve önceden kazanılmış bilginin bozulması riski taşır.
PyTorch ile pratik uygulama
Aşağıdaki örnek, ImageNet ağırlıklarıyla gelen ResNet-18 modelini üç sınıflı yerel bir probleme uyarlar:
import torch.nn as nn
from torchvision.models import resnet18, ResNet18_Weights

# Önceden öğrenilmiş ağırlıkları yükle
model = resnet18(weights=ResNet18_Weights.DEFAULT)

# Özellik çıkarıcı katmanları dondur
for parameter in model.parameters():
    parameter.requires_grad = False

# Eski sınıflandırıcıyı hedef probleme uygun katmanla değiştir
input_size = model.fc.in_features
model.fc = nn.Linear(input_size, 3)
requires_grad = False işlemi, geri yayılım sırasında gövde parametrelerinin güncellenmesini engeller. Yeni Linear katmanı ise üç yerel sınıf için skor üretir. Optimizasyon yalnızca eğitilebilir parametrelerle kurulmalıdır:
optimizer = torch.optim.Adam(
    filter(lambda p: p.requires_grad, model.parameters()),
    lr=1e-3
)
İlk eğitimden sonra başarı yetersizse son katman grubu açılabilir:
for parameter in model.layer4.parameters():
    parameter.requires_grad = True
Bu aşamada öğrenme oranını örneğin $10^{-4}$ veya $10^{-5}$ seviyesine düşürmek önemlidir. Büyük güncellemeler, modelin yararlı ağırlıklarını bozabilir.
Ne zaman işe yarar?
Transfer öğrenme özellikle etiketlemenin pahalı olduğu sağlık, uydu görüntüleme, endüstriyel hata tespiti ve doğal dil işleme projelerinde değerlidir. Kazanç, kaynak görev ile hedef görev arasındaki benzerliğe bağlıdır. Genel görüntülerle eğitilmiş bir model röntgenlerde faydalı temel desenler sunabilir; ancak ses verisine doğrudan aktarılması anlamlı değildir.
Başarıyı değerlendirirken yalnızca doğruluk kullanılmamalıdır. Dengesiz veri setlerinde precision, recall ve $F_1$ skoru daha açıklayıcıdır:
\[F_1 = 2 \cdot \frac{Precision \cdot Recall}{Precision + Recall}\]Sonuç olarak iyi bir strateji, önce gövdeyi dondurup yeni başlığı eğitmek, ardından doğrulama performansını izleyerek katmanları kontrollü biçimde açmaktır. Veri artırma, erken durdurma ve düşük öğrenme oranı da süreci destekler. Böylece dev bir model, küçük veri setiniz için pahalı bir yabancı olmaktan çıkıp hızla işe alışan deneyimli bir ekip arkadaşına dönüşür.
Yorumlar