İçindekiler
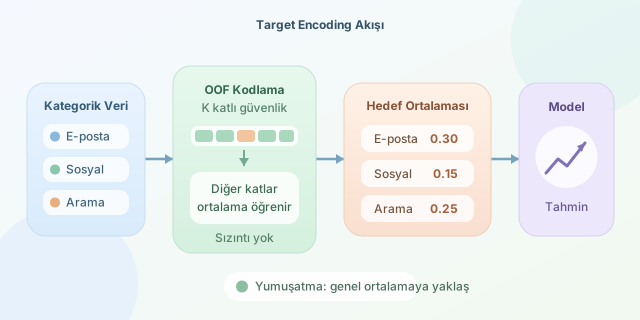
Kategorik veriler, makine öğrenmesi projelerinin görünmez kahramanlarıdır: şehir, ürün kategorisi, kampanya kodu, müşteri segmenti veya film türü gibi alanlar çoğu zaman tahmin gücünün önemli kısmını taşır. Ancak modeller metin etiketlerini doğrudan anlayamaz. Target encoding, kategorileri hedef değişkenle olan ilişkilerine göre sayısal hale getirerek bu sorunu güçlü ve pratik biçimde çözer. ``
Temel fikir: Kategorinin hedef ortalaması
Target encoding yaklaşımında her kategori, o kategoriye ait gözlemlerin hedef değişken ortalamasıyla değiştirilir. Örneğin bir e-ticaret veri setinde hedefimiz satın_aldi olsun: satın alanlar için 1, almayanlar için 0. kanal sütununda E-posta, Sosyal Medya ve Arama kategorileri varsa, her kanalın dönüşüm oranı hesaplanır.
Burada $c$ kategori, $n_c$ o kategorinin gözlem sayısı, $y_i$ ise hedef değeridir. E-posta kanalındaki 100 ziyaretçinin 30’u alışveriş yaptıysa, E-posta için kodlanmış değer $0.30$ olur. Böylece model, yalnızca bir etiketi değil, o etiketin hedefle tarihsel ilişkisini de görür.
| Kanal | Gözlem Sayısı | Satın Alma Ortalaması | Target Encoded Değer |
|---|---|---|---|
| E-posta | 100 | 0.30 | 0.30 |
| Sosyal Medya | 80 | 0.15 | 0.15 |
| Arama | 120 | 0.25 | 0.25 |
Bu yöntem özellikle yüksek kardinaliteli sütunlarda, yani binlerce farklı değere sahip ürün_id, posta_kodu veya satıcı gibi alanlarda one-hot encoding’e göre çok daha kompakt olabilir.
Neden doğrudan ortalama kullanmak risklidir?
Küçük örneklemlerde ortalama güvenilir değildir. Sadece iki gözlemi olan bir kategoride iki başarı görülürse oran 1.00 çıkar; bu, kategorinin gerçekten mükemmel olduğu anlamına gelmeyebilir. Ayrıca eğitim verisinin hedefini aynı satırı kodlamak için kullanmak veri sızıntısı yaratır. Model adeta sınav cevap anahtarını önceden görür ve eğitimde harika, gerçek hayatta ise vasat sonuç verir.
Bu nedenle smoothing (yumuşatma) uygulanır. Kategori ortalaması, veri setinin genel hedef ortalamasına yaklaştırılır:
\[\text{TE}_{smooth}(c) = \frac{n_c\mu_c + m\mu}{n_c+m}\]$\mu_c$ kategori ortalaması, $\mu$ genel ortalama, $m$ ise yumuşatma gücüdür. $n_c$ büyüdükçe kategori verisine daha çok, azaldıkça genel ortalamaya daha fazla güvenilir. İstatistiksel açıdan bu, belirsiz kategorilere temkinli davranan bir tür düzenlileştirmedir.
Güvenli uygulama: Out-of-fold encoding
Sızıntıyı engellemenin altın standardı out-of-fold (OOF) target encoding’dir. Eğitim verisi $K$ parçaya bölünür. Her parça için kodlama, o parçanın dışındaki $K-1$ parçada hesaplanır. Böylece bir satır kendi hedef değerinden yararlanamaz. Test verisi ise eğitim setinin tamamından üretilen eşleme ile dönüştürülür.
import pandas as pd
from sklearn.model_selection import KFold

# df: kanal ve satin_aldi sütunlarını içeriyor
df = pd.DataFrame({
    "kanal": ["Eposta", "Arama", "Eposta", "Sosyal", "Arama", "Sosyal"],
    "satin_aldi": [1, 0, 0, 1, 1, 0]
})

global_mean = df["satin_aldi"].mean()
df["kanal_te"] = 0.0
kf = KFold(n_splits=3, shuffle=True, random_state=42)

for train_idx, valid_idx in kf.split(df):
    train = df.iloc[train_idx]
    mapping = train.groupby("kanal")["satin_aldi"].mean()
    df.loc[df.index[valid_idx], "kanal_te"] = (
        df.loc[df.index[valid_idx], "kanal"].map(mapping).fillna(global_mean)
    )
Bu kod, her doğrulama parçasını yalnızca diğer parçalardan öğrenilen kanal ortalamalarıyla dönüştürür. Gerçek projelerde category_encoders gibi kütüphaneler yumuşatma seçenekleriyle süreci kolaylaştırabilir; yine de çapraz doğrulama mantığını kontrol etmek sizin sorumluluğunuzdadır.
| Yöntem | Güçlü Yanı | Zayıf Yanı | Uygun Senaryo |
|---|---|---|---|
| One-hot encoding | Şeffaf ve güvenli | Çok fazla sütun üretir | Az kategorili alanlar |
| Label encoding | Hızlı ve basit | Sahte sıralama ima eder | Bazı ağaç tabanlı modeller |
| Target encoding | Hedef bilgisini taşır | Sızıntı riski vardır | Yüksek kardinalite, yeterli veri |
Yeni veya eğitimde hiç görülmemiş kategoriler için genel ortalamayı kullanmak güvenli bir varsayımdır. Sonuç olarak target encoding sihirli değnek değil; doğru çapraz doğrulama, smoothing ve sağlam bir değerlendirme düzeniyle birleştiğinde kategorik verileri güçlü tahmin sinyallerine dönüştüren etkili bir özellik mühendisliği tekniğidir.
Yorumlar