İçindekiler
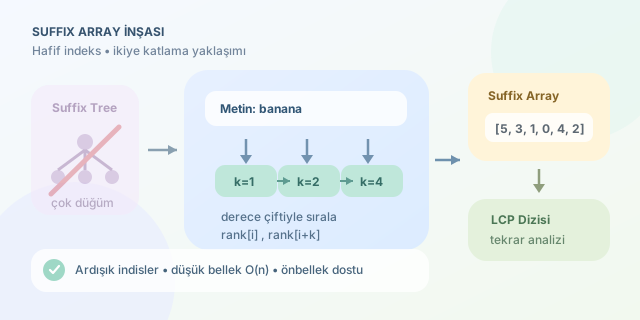
Bir metin içinde desen aramak, tekrarları bulmak veya sözlük sırasına göre son ekleri incelemek istediğimizde suffix tree güçlü bir çözümdür. Ancak düğümler, bağlantılar ve yüksek bellek tüketimi yüzünden uygulaması biraz “orman yangınına” dönüşebilir. Suffix array ise aynı fikirlerin önemli bir bölümünü yalnızca bir tamsayı dizisiyle sunar: Daha sade, önbellek dostu ve pratik!
``
Suffix array nedir?
Uzunluğu $n$ olan bir $S$ metninin $i$ konumundan başlayan kısmına suffix, yani son ek denir:
\[suffix(i) = S[i..n-1]\]Suffix array, bütün son eklerin sözlük sırasına göre dizilmesiyle elde edilen başlangıç indislerini saklar. Örneğin banana için son ekler sıralandığında:
| İndis | Son ek |
|---|---|
| 5 | a |
| 3 | ana |
| 1 | anana |
| 0 | banana |
| 4 | na |
| 2 | nana |
Dolayısıyla sonuç $SA=[5,3,1,0,4,2]$ olur. Dikkat: Dizinin kendisi metin parçalarını değil, yalnızca indisleri tutar. Bu nedenle temel bellek maliyeti $O(n)$ seviyesindedir.
Neden suffix tree yerine kullanılır?
| Özellik | Suffix tree | Suffix array |
|---|---|---|
| Bellek | Yüksek, çok sayıda düğüm içerir | Düşük, indis dizisi saklar |
| Uygulama | Karmaşık | Görece kolay |
| Desen arama | $O(m)$ | İkili aramayla yaklaşık $O(m\log n)$ |
| Önbellek uyumu | Genellikle zayıf | Ardışık dizi nedeniyle güçlü |
| Ek yapılar | Kenarlar ve bağlantılar | LCP dizisiyle zenginleşir |
Burada $m$, aranan desenin uzunluğudur. Suffix tree teoride daha hızlı arama sunsa da gerçek uygulamalarda bellek yerleşimi ve sabit maliyetler suffix array’i oldukça cazip kılar.
İnşa fikri: Uzunluğu ikiye katla
En basit yöntem bütün son ekleri üretip sıralamaktır; fakat metin parçalarını kopyalamak $O(n^2)$ bellek ve zaman maliyetine yaklaşabilir. Daha akıllı doubling yöntemi, önce tek karakterlik, sonra 2, 4, 8 karakterlik öneklerin sıralama derecelerini hesaplar.
Her turda bir son ek şu çiftle temsil edilir:
\[key(i)=(rank[i], rank[i+k])\]Burada $k$ önceki turda sıralanmış parça uzunluğudur. Eşit çiftler aynı yeni dereceyi alır. Her turda $k$ iki katına çıktığı için en fazla $\lceil\log_2 n\rceil$ tur gerekir.
def build_suffix_array(text):
    n = len(text)
    sa = list(range(n))
    rank = [ord(char) for char in text]
    k = 1

    while k < n:
        # Her son eki, iki parçanın mevcut derecesiyle sıralar.
        sa.sort(key=lambda i: (
            rank[i],
            rank[i + k] if i + k < n else -1
        ))

        new_rank = [0] * n
        for pos in range(1, n):
            previous, current = sa[pos - 1], sa[pos]
            previous_key = (
                rank[previous],
                rank[previous + k] if previous + k < n else -1
            )
            current_key = (
                rank[current],
                rank[current + k] if current + k < n else -1
            )
            new_rank[current] = new_rank[previous] + (current_key != previous_key)

        rank = new_rank
        k *= 2

    return sa

print(build_suffix_array("banana"))  # [5, 3, 1, 0, 4, 2]
Python’ın karşılaştırmalı sıralamasını kullanan bu sürüm yaklaşık $O(n\log^2 n)$ zamanda çalışır. Dereceler counting sort veya radix sort ile sıralanırsa maliyet $O(n\log n)$ düzeyine indirilebilir.
LCP ile yetenekleri artırmak
Suffix array çoğunlukla LCP dizisiyle birlikte kullanılır. LCP, sıralamadaki komşu son eklerin ortak önek uzunluklarını saklar. Kasai algoritması bunu $O(n)$ zamanda hesaplar. En büyük LCP değeri metindeki en uzun tekrarlanan parçayı verir; aralık minimum sorguları eklendiğinde iki son ekin ortak öneki de hızlıca bulunabilir.
Sonuç olarak suffix array; metin indeksleme, biyoinformatik, sıkıştırma ve tekrar analizi için güçlü bir denge kurar. Suffix tree bir spor otomobilse suffix array ekonomik bir hatchback gibidir: Biraz daha kontrollü kullanılır, çok daha az yer kaplar ve çoğu yolculukta sizi aynı hedefe ulaştırır.
Yorumlar