İçindekiler
Büyük dil modelleri etkileyici metinler üretirken her token için devasa hesaplamalar yapar. Bu durum, özellikle uzun yanıtlar ve eşzamanlı kullanıcılar söz konusu olduğunda gecikmeyi büyütür. Speculative decoding (spekülatif çözümleme), kaliteyi belirgin biçimde düşürmeden üretimi hızlandırmak için küçük ve hızlı bir modelin yaptığı tahminleri büyük modelle topluca doğrulayan yaratıcı bir çıkarım tekniğidir.
``
Temel fikir: Önce taslak, sonra denetim
Klasik otoregresif üretimde ana model, her adımda yalnızca bir sonraki tokenı hesaplar:
\[p(x_{1:n}) = \prod_{t=1}^{n} p(x_t \mid x_{<t})\]Yani model “Bugün hava…” ifadesinden sonra tek token üretir, ardından yeni bağlamla bir token daha hesaplar. Büyük modelin bu döngüyü yüzlerce kez çalıştırması pahalıdır.
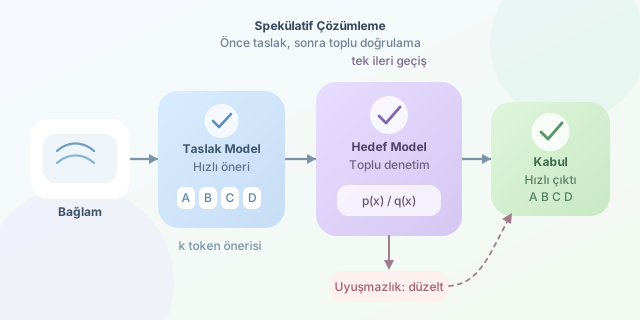
Speculative decoding ise iki oyuncu kullanır: taslak (draft) model ve hedef (target) model. Hafif taslak model, $k$ adet olası tokenı hızlıca önerir. Ardından güçlü hedef model bu tokenları tek bir ileri geçişte değerlendirir. Uygun bulunan öneriler kabul edilir; ilk uyuşmazlıkta hedef modelin doğru dağılımından örnekleme yapılır. Böylece kaliteyi belirleyen son otorite her zaman büyük modeldir.
| Özellik | Klasik decoding | Speculative decoding |
|---|---|---|
| Token üretim ritmi | Büyük modelden tek tek | Küçük modelden blok önerisi |
| Doğrulama | Gerekmez | Hedef model önerileri denetler |
| Kalite dağılımı | Hedef modele bağlı | Doğru kabul kuralıyla hedef modele eşdeğer |
| Hız kazancı | Sınırlı | Kabul oranı ve paralellikte artar |
Kabul olasılığı neden önemlidir?
Taslak modelin $q(x)$, hedef modelin ise $p(x)$ dağılımını ürettiğini düşünelim. Önerilen token $x$ için yaygın kabul kuralı şöyledir:
\[a(x) = \min\left(1, \frac{p(x)}{q(x)}\right)\]Rastgele çekilen bir $u \sim U(0,1)$ değeri $a(x)$ değerinden küçükse token kabul edilir. Taslak model hedef modelle ne kadar uyumluysa, kabul oranı o kadar yükselir. Uyuşmazlıkta kullanılan düzeltme örneklemesi, ortaya çıkan metnin istatistiksel olarak hedef modelden doğrudan örnekleme ile aynı dağılıma sahip kalmasına yardım eder. İşin sihri “küçük model büyük modelin yerine geçiyor” demek değildir; küçük model büyük modelin bekleme süresini daha verimli kullanır.
# Kavramsal akış: gerçek uygulamada olasılık düzeltmesi daha ayrıntılıdır.
def speculative_generate(prompt, draft, target, k=4):
    proposal = draft.generate(prompt, max_new_tokens=k)
    target_scores = target.score_tokens(prompt, proposal)

    accepted = []
    for token, p, q in zip(proposal, target_scores.p, target_scores.q):
        if random.random() < min(1.0, p / q):
            accepted.append(token)
        else:
            accepted.append(target_scores.sample_corrected())
            break
    return prompt + accepted
Bu örnekte draft.generate hızlı aday dizisini hazırlar. target.score_tokens ise adayların hedef model açısından olasılıklarını hesaplar. Üretim sunucularında bu adımlar GPU toplu işleme, KV cache ve dikkatlice tasarlanmış örnekleme mantığıyla çok daha karmaşık hâle gelir.
Ne zaman kazandırır, ne zaman zorlanır?
Kazanç kabaca kabul edilen token sayısı arttıkça büyür. Ancak taslak model çok zayıfsa sık sık reddedilen öneriler, doğrulama maliyetini gereksiz kılabilir. Ayrıca $k$ değerini aşırı büyütmek de her zaman iyi değildir: Daha uzun bloklar daha çok paralellik sunar ama sonlara doğru tahmin isabeti azalabilir.
| Senaryo | Beklenen sonuç | Neden |
|---|---|---|
| Benzer aileden taslak ve hedef model | Yüksek hızlanma | Dağılımlar daha uyumludur |
| Kod tamamlama ve tekrarlı kalıplar | Genellikle iyi | Sonraki tokenlar daha öngörülebilirdir |
| Çok yaratıcı, yüksek sıcaklıklı üretim | Değişken | Olasılık dağılımı daha dağınıktır |
| Zayıf taslak model | Düşük kazanç | Reddetme oranı yükselir |
Speculative decoding, model eğitmekten çok çıkarım altyapısını iyileştiren bir tekniktir. Doğru taslak modeli, uygun blok boyutunu ve sağlam kabul-düzeltme kurallarını seçtiğinizde; kullanıcı aynı kalitede yanıt görürken tokenlar ekrana çok daha hızlı akabilir. Kısacası, büyük modele acele ettirmek yerine ona akıllıca hazırlanmış bir taslak sunarsınız.
Yorumlar