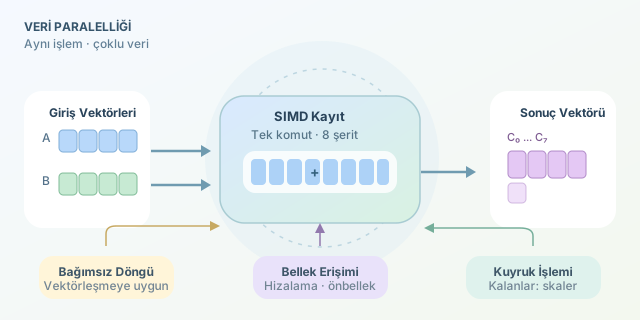
Modern işlemciler yalnızca daha yüksek saat hızlarıyla değil, aynı anda birden fazla veriyi işleyebilme yetenekleriyle de hız kazanır. SIMD (Single Instruction, Multiple Data), yani Tek Komut Çoklu Veri yaklaşımı, özellikle dizi, matris, görüntü, ses ve bilimsel hesaplama gibi birbirinden bağımsız sayısal işlemlerde büyük performans artışı sağlar. Fikir basittir: Dört sayıyı tek tek toplamak yerine, dört sayıyı taşıyan bir vektör kaydı üzerinde tek toplama komutu çalıştırılır. ``
SIMD’nin teorik temeli veri paralelliğidir. Bir döngüdeki her iterasyon, diğerlerinden bağımsızsa işlemci bu iterasyonları paketleyebilir. Örneğin $C_i = A_i + B_i$ işlemi, her $i$ için aynı komutu uygular. Skaler yaklaşımda işlemci mantıksal olarak her eleman için ayrı bir toplama yürütürken, 256 bitlik AVX kaydı sekiz adet 32 bit float değeri aynı anda taşıyabilir:
Bu, teorik olarak sekiz kat veri genişliği anlamına gelir. Ancak gerçek dünyada hızlanma her zaman tam sekiz kat değildir. Bellek bant genişliği, veri hizalaması, dallanma, önbellek davranışı ve komut bağımlılıkları sonucu etkiler. SIMD bir turbo düğmesidir; fakat motorun geri kalanı hazır değilse beklenen uçuş hissini vermeyebilir.
| Yaklaşım | İşleme biçimi | Güçlü yanı | Sınırlaması |
|---|---|---|---|
| Skaler | Bir komut, bir veri | Basit ve esnek kod | Büyük dizilerde daha çok komut |
| SIMD | Bir komut, çok veri | Sayısal döngülerde yüksek verim | Düzenli, bağımsız veriye ihtiyaç duyar |
| Çok çekirdek | Birden çok iş akışı | Büyük iş yüklerini bölüştürür | Senkronizasyon maliyeti oluşabilir |
| GPU | Çok geniş paralellik | Binlerce benzer işlem | Veri aktarımı ve programlama maliyeti |
C++ tarafında SIMD kullanmanın birkaç yolu vardır: derleyicinin otomatik vektörleştirmesine güvenmek, platforma özgü intrinsic fonksiyonları çağırmak veya taşınabilir SIMD kütüphanelerinden yararlanmak. Aşağıdaki örnek AVX intrinsic’leri ile iki float dizisini toplar. Her turda sekiz eleman işlenir; geriye kalan elemanlar için skaler bir kuyruk döngüsü bulunur.
#include <immintrin.h>

void topla(const float* a, const float* b, float* c, int n) {
    int i = 0;

    // AVX: Her iterasyonda 8 adet float toplanır.
    for (; i + 7 < n; i += 8) {
        __m256 va = _mm256_loadu_ps(a + i);
        __m256 vb = _mm256_loadu_ps(b + i);
        __m256 sonuc = _mm256_add_ps(va, vb);
        _mm256_storeu_ps(c + i, sonuc);
    }

    // Dizinin 8'e bölünmeyen son elemanları.
    for (; i < n; ++i) {
        c[i] = a[i] + b[i];
    }
}
Buradaki _mm256_loadu_ps, hizasız bellek adresinden veri yükler. loadu kullanımı pratiktir; fakat uygun hizalama ve düzenli erişim kalıbı bazı mimarilerde daha iyi sonuç verebilir. Derleme sırasında AVX desteğini etkinleştirmek de gerekir: GCC veya Clang için örneğin -O3 -mavx kullanılabilir. Daha yeni işlemcilerde AVX2 ya da AVX-512 farklı veri türleri ve daha geniş kayıtlar sunar.
SIMD için uygun döngüler genellikle şu özelliği taşır: Her eleman kendi indeksindeki verilerden hesaplanır. Örneğin piksel parlaklığı ayarlama, vektör toplama, ses örneği ölçekleme ve makine öğrenmesi tensör işlemleri iyi adaylardır. Buna karşılık, sonuc[i] değerinin sonuc[i - 1] değerine bağlı olduğu ardışık algoritmalar vektörleştirmeyi zorlaştırır.
| Kontrol listesi | Neden önemli? |
|---|---|
| İterasyonlar bağımsız mı? | Aynı komutun farklı verilere güvenle uygulanmasını sağlar. |
| Veri ardışık mı? | Önbellek ve vektör yükleme işlemlerini verimli kılar. |
| Döngüde dallanma az mı? | Farklı koşullar SIMD şeritlerini boşa çıkarabilir. |
| Ölçüm yapıldı mı? | Kazancı varsaymak yerine profil çıkararak doğrular. |
Sonuç olarak SIMD, algoritmayı değiştirmeden veri düzeyinde paralellik yakalamanın güçlü yoludur. Önce temiz, öngörülebilir döngüler yazın; ardından derleyicinin vektörleştirme raporlarını ve gerçek benchmark sonuçlarını inceleyin. Doğru iş yükünde SIMD, işlemcinizin gizli çoklu çalışma şeritlerini görünür hale getirir.
Yorumlar