İçindekiler
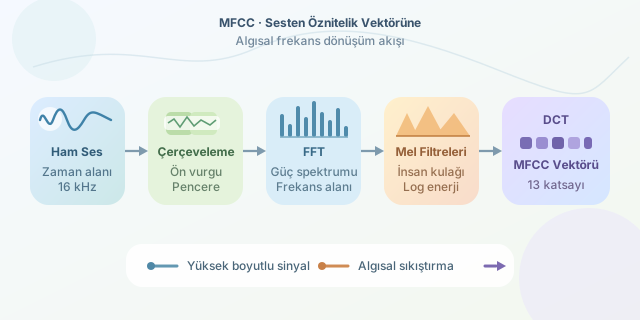
Bir bilgisayar için konuşma, yalnızca zaman boyunca değişen sayılardan oluşur. İnsan kulağı ise bu değişimleri doğrusal biçimde algılamaz: düşük frekanslardaki küçük farklara oldukça duyarlıyken yüksek frekanslarda daha geniş aralıkları benzer kabul eder. Mel-Frequency Cepstral Coefficients (MFCC), ses sinyalini bu algısal özelliğe göre sıkıştırarak konuşma tanıma algoritmalarının kullanabileceği kompakt öznitelik vektörlerine dönüştürür. ``
MFCC neden gereklidir?
Ham bir ses kaydı, örneğin 16 kHz örnekleme hızında, her saniye 16.000 genlik değeri üretir. Bu değerleri doğrudan bir modele vermek hem maliyetlidir hem de konuşmacının ses yüksekliği veya kayıt gürültüsü gibi ayrıntılara aşırı duyarlılık yaratabilir. MFCC, konuşmanın kimliğini taşıyan spektral zarfı öne çıkarırken gereksiz ayrıntıları azaltır.
| Temsil | Boyut | Algısal uyum | Tipik kullanım |
|---|---|---|---|
| Ham dalga biçimi | Çok yüksek | Düşük | Uçtan uca derin öğrenme |
| FFT spektrumu | Yüksek | Frekanslar doğrusal | Spektral analiz |
| Mel spektrogramı | Orta | İnsan işitmesine yakın | Sinir ağları |
| MFCC | Düşük | Algısal ve sıkıştırılmış | Konuşma tanıma, sınıflandırma |
Dönüşüm adımları
1. Ön vurgu ve çerçeveleme
Ön vurgu filtresi, konuşma sinyalinde genellikle daha zayıf olan yüksek frekansları güçlendirir:
\[y[n] = x[n] - \alpha x[n-1]\]Burada $\alpha$ çoğunlukla 0,95 ile 0,97 arasındadır. Ardından sinyal, yaklaşık 20–30 milisaniyelik örtüşen çerçevelere ayrılır. Konuşma bütünüyle durağan değildir; ancak bu kısa aralıklarda yaklaşık durağan kabul edilebilir.
Çerçeve kenarlarındaki ani kesilmeleri azaltmak için Hamming penceresi uygulanır:
\[w[n] = 0.54 - 0.46\cos\left(\frac{2\pi n}{N-1}\right)\]2. Frekans alanına geçiş
Her çerçevenin Hızlı Fourier Dönüşümü alınır. Böylece zaman alanındaki örnekler, hangi frekansın ne kadar enerji taşıdığını gösteren bir spektruma dönüşür:
\[X[k] = \sum_{n=0}^{N-1} x[n]w[n]e^{-j2\pi kn/N}\]MFCC hesabında çoğunlukla güç spektrumu $P[k] = \vert X[k]\vert ^2/N$ kullanılır.
3. Mel filtre bankası
İnsan işitmesindeki doğrusal olmayan frekans algısı, Hertz değerlerinin Mel ölçeğine çevrilmesiyle modellenir:
\[m = 2595\log_{10}\left(1 + \frac{f}{700}\right)\]Bu ölçekte eşit uzaklıklarla yerleştirilen üçgensel filtreler, güç spektrumundaki enerjileri toplar. Düşük frekanslarda filtreler dar, yüksek frekanslarda geniştir. Başka bir deyişle sistem, bas bölgesine büyüteçle, tiz bölgesine ise biraz uzaktan bakar.
4. Logaritma ve DCT
Filtre enerjilerinin logaritması alınır. Bu işlem hem insanın ses şiddeti algısını taklit eder hem de çarpımsal etkileri toplamsal hâle getirir. Sonrasında Ayrık Kosinüs Dönüşümü uygulanır:
\[c_n = \sum_{m=1}^{M} \log(E_m)\cos\left[\frac{\pi n}{M}(m-0.5)\right]\]İlk 12 veya 13 katsayı genellikle yeterlidir. Yüksek dereceli katsayılar hızlı spektral değişimleri temsil ettiğinden çoğu uygulamada elenir.
Python ile MFCC çıkarımı
Aşağıdaki kod, bir ses dosyasından 13 MFCC katsayısı çıkarır ve her çerçeveyi bir öznitelik vektörüne dönüştürür:
import librosa
import numpy as np

# Sesi 16 kHz örnekleme hızıyla yükle
y, sr = librosa.load("konusma.wav", sr=16000)

mfcc = librosa.feature.mfcc(
    y=y,
    sr=sr,
    n_mfcc=13,
    n_fft=400,       # 25 ms çerçeve
    hop_length=160,  # 10 ms kaydırma
    n_mels=40
)

# Zaman eksenini önce getir: (çerçeve, katsayı)
features = mfcc.T
print(features.shape)
Konuşmadaki hareketi yakalamak için MFCC’lere birinci ve ikinci türevler, yani delta ve delta-delta katsayıları da eklenebilir. Böylece model yalnızca mevcut spektral şekli değil, bu şeklin nasıl değiştiğini de öğrenir. Sonuç olarak MFCC; akustik sinyali, kulağın algısına yaklaşan, düşük boyutlu ve makine öğrenmesine uygun bir sayısal özete dönüştüren güçlü bir köprüdür.
Yorumlar