Bir satranç ustası tahtaya baktığında 32 ayrı taşı tek tek saymaz; anlamlı örüntüleri, tehditleri ve tanıdık planları neredeyse anında görür. Bilişsel modelleme, bu olağanüstü insan becerisini yalnızca en iyi hamleyi bulan bir motor üretmek için değil, oyuncunun nasıl düşündüğünü yaklaşık olarak yeniden kurmak için inceler. Amaç, bilgisayarın satrançta güçlü olmasından öte, dikkatini nereye yönelttiğini ve hangi bilgiyi öncelediğini anlamaktır. ``
Bu alanın temel kavramlarından biri chunking, yani parçalama ya da örüntü kümeleme yaklaşımıdır. Acemi bir oyuncu açıkta kalan fili, piyonu ve şahı bağımsız nesneler olarak algılayabilir. Usta ise “vezir kanadında azınlık hücumu”, “arka sıradaki mat motifi” veya “zayıf koyu kareler” gibi daha büyük yapıları tek bir zihinsel birim halinde kodlar. Bu fark, ham hesaplama hızından çok, belleğe hangi bilginin verimli biçimde yerleştirildiğiyle ilgilidir.
Bir pozisyonun bilişsel olarak önemli özelliklerini $x$ vektörüyle gösterelim. Bu vektör; taşların konumlarını, şah güvenliğini, merkez kontrolünü, tehditleri ve piyon yapısını içerebilir. Model, ustanın dikkat dağılımını $p(a_i \mid x)$ ile ifade eder. Burada $a_i$, tahtadaki belirli bir kareye ya da taşa yönelen dikkat eylemidir. Basitçe amaç şudur:
\[\hat{a} = \arg\max_{a_i} p(a_i \mid x)\]Yani model, oyuncunun ilk bakışta hangi kareyi inceleme olasılığının en yüksek olduğunu tahmin etmeye çalışır. Bu yaklaşım, yalnızca Stockfish benzeri bir değerlendirme puanı üretmekten farklıdır: Motorun seçtiği hamle doğru olabilir, fakat insanın düşündüğü aday hamleler ve izlediği görsel rota bambaşka olabilir.
| Boyut | Acemi oyuncu | Usta oyuncu | Bilişsel modelin hedefi |
|---|---|---|---|
| Tahta algısı | Tekil taşlara odaklanır | Örüntü ve ilişki görür | Anlamlı özellik kümeleri çıkarmak |
| Aday hamle | Çok sayıda rastgele seçenek | Az sayıda güçlü aday | Hamle filtreleme sürecini öğrenmek |
| Hesaplama | Kısa ama dağınık varyantlar | Kritik varyantlara derinleşme | Dikkat ve arama önceliği tahmini |
| Bellek | Konum ayrıntıları çabuk kaybolur | Tanıdık şablonlar hızla çağrılır | Açılış, motif ve yapı belleği kurmak |
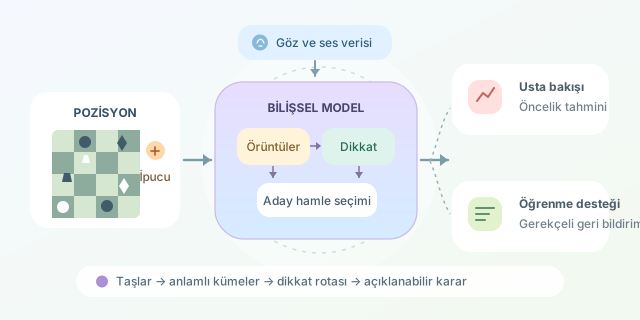
Akademik çalışmalarda veri çoğu zaman göz izleme cihazları, sesli düşünme protokolleri ve hamle kayıtlarından gelir. Göz izleme verisi, bir oyuncunun baktığı yerin düşündüğü şeyle her zaman aynı olmadığını da gösterir; yine de dikkat mekanizması için güçlü bir ipucudur. Sesli protokoller ise “şah güvenliği zayıf” gibi sözel gerekçeleri yakalar. Bu veriler bir araya getirildiğinde, model hem hamleyi hem de gerekçeyi tahmin edebilir.
Örneğin dikkat ağırlıklı basit bir aday hamle sıralayıcısı şöyle tasarlanabilir:
import numpy as np

# Özellikler: şah tehdidi, taş kaybı, merkez kontrolü, taktik motif
weights = np.array([0.45, 0.30, 0.10, 0.15])

candidates = {
    "Nf3": np.array([0.2, 0.0, 0.7, 0.1]),
    "Qh5": np.array([0.8, 0.1, 0.1, 0.9]),
    "d4":  np.array([0.1, 0.0, 0.9, 0.0])
}

scores = {move: features @ weights for move, features in candidates.items()}
print(sorted(scores.items(), key=lambda item: item[1], reverse=True))
Bu kod bir satranç motoru değildir; amaç, ustaların çoğu zaman önce taktik aciliyeti ve şah güvenliğini taradığı fikrini görünür kılmaktır. Gerçek modellerde bu özellikler elle yazılmak yerine sinir ağlarıyla öğrenilebilir. Transformer tabanlı mimariler, taşlar arası uzak ilişkileri; grafik sinir ağları ise kareleri ve saldırı-savunma bağlarını grafik olarak ele alabilir.
Bununla birlikte başarı ölçütü yalnızca hamle doğruluğu olmamalıdır. Bir model ustayla aynı hamleyi seçip tamamen farklı bir gerekçeyle seçebilir. Bu nedenle araştırmacılar aday hamle benzerliği, bakış rotası uyumu, açıklama tutarlılığı ve hata türleri gibi ölçümleri birlikte değerlendirir. En heyecan verici sonuç ise eğitim teknolojilerinde ortaya çıkar: Sistem, öğrenciye yalnızca “bu hamle yanlış” demek yerine, “önce rakibin şahına yönelik tehdidi fark etmeliydin” diyebilir. Böylece makine, satrancı oynamaktan bir adım ileri geçerek satranç düşüncesini öğretmeye yaklaşır.
Yorumlar