Bir yazılım sistemindeki seçenek kombinasyonları arttıkça, “bu kuralların hepsini aynı anda sağlayan bir yapı var mı?” sorusu hızla zorlaşır. Ders programı hazırlama, devre doğrulama, bağımlılık çözümü ve test üretimi gibi işlerde karşımıza çıkan bu sorunun merkezinde Boolean Satisfiability Problem (SAT) bulunur. SAT, teorik olarak NP-tam olsa da modern çözücüler milyonlarca değişkenli bazı gerçek dünya örneklerini şaşırtıcı hızda çözebilir. Bu başarının temel taşlarından biri, klasik ama etkili DPLL algoritmasıdır.
``
SAT probleminde her değişken yalnızca iki değer alır: doğru ($1$) veya yanlış ($0$). Problem çoğunlukla Konjonktif Normal Form (CNF) ile ifade edilir. CNF, parantez içindeki veya bağlarının dışarıdan ve bağlarıyla birleştirildiği yapıdır:
\[F = (a \lor \neg b) \land (b \lor c) \land (\neg a \lor \neg c)\]Burada her parantez bir clause (kloz), klozun içindeki $a$ veya $\neg b$ gibi parçalar ise literal adını alır. Amaç, tüm klozları aynı anda doğru yapan bir atama bulmaktır. Örneğin $a=1$, $b=1$, $c=0$ seçimi ilk iki klozu doğru yapar; ancak üçüncü kloz $(\neg a \lor \neg c)$ de $\neg c$ sayesinde doğrudur. Dolayısıyla formül sağlanabilirdir.
| Kavram | Anlamı | Örnek |
|---|---|---|
| Değişken | Doğru/yanlış değer alan sembol | $a$ |
| Literal | Değişken veya değili | $a$, $\neg a$ |
| Kloz | Literal’lerin veya birleşimi | $(a \lor \neg b)$ |
| CNF | Klozların ve birleşimi | $(a) \land (\neg b \lor c)$ |
| SAT | En az bir geçerli atama vardır | “Evet, çözüm var” |
| UNSAT | Hiçbir atama tüm klozları sağlamaz | “Kurallar çelişkili” |
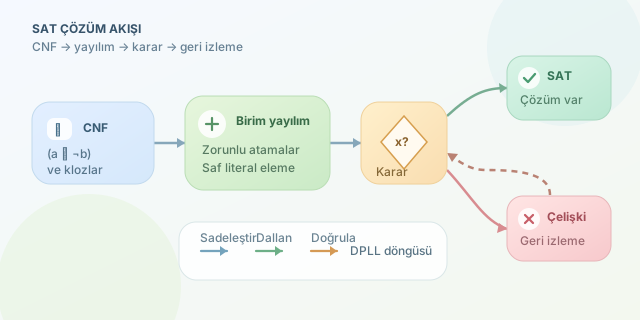
DPLL, adını Davis, Putnam, Logemann ve Loveland’dan alır. Temelde akıllı bir geri izleme aramasıdır: Bir değişkene değer verir, sonuçlarını yayar, çelişki varsa geri döner ve diğer seçeneği dener. Ancak onu sıradan $2^n$ olasılığı deneyen kaba kuvvet yaklaşımından ayıran iki güçlü sadeleştirme vardır: birim yayılım ve saf literal eleme.
Birim yayılımda tek literal içeren bir kloz zorunlu karar üretir. Örneğin $(x)$ klozu varsa $x=1$ olmak zorundadır. Ardından $(\neg x \lor y)$ klozu, $x=1$ nedeniyle $(y)$ haline gelir; böylece $y=1$ de zorunlu olur. Bu zincirleme etki, tahmin yapmadan çok sayıda değişkeni belirleyebilir. Saf literal ise formülde yalnızca tek kutuplulukta görünen değişkendir. Eğer $z$ sadece $z$ olarak geçiyor, $\neg z$ hiç görünmüyorsa, $z=1$ seçimi hiçbir klozu bozmaz.
def dpll(clauses, assignment={}):
    clauses, assignment = unit_propagate(clauses, assignment)
    if clauses is None:          # Boş kloz: çelişki
        return None
    if not clauses:              # Kalan kloz yok: çözüm bulundu
        return assignment

    variable = choose_variable(clauses)
    for value in (True, False):
        result = dpll(assign(clauses, variable, value),
                      {**assignment, variable: value})
        if result is not None:
            return result
    return None
Bu kod, DPLL’nin iskeletini gösterir. unit_propagate, zorunlu sonuçları uygular; choose_variable ise dallanılacak değişkeni belirler. İlk dal başarısız olursa algoritma geri izleme yapar. Gerçek çözücülerde bu seçim rastgele değildir: değişkenin çok sayıda klozda görünmesi gibi sezgiseller aramayı ciddi biçimde küçültür.
| Yaklaşım | Temel fikir | Pratik sonuç |
|---|---|---|
| Kaba kuvvet | Tüm $2^n$ atamayı dene | Küçük örneklerde yeterli |
| DPLL | Dallanma, yayılım, geri izleme | Orta ölçekli problemler için güçlü |
| CDCL | DPLL + çatışma öğrenme | Modern endüstriyel çözücü standardı |
Modern SAT çözücüleri çoğunlukla DPLL’nin gelişmiş akrabası olan CDCL kullanır. CDCL, bir çelişki gördüğünde yalnızca geri dönmez; çelişkiye yol açan karar kombinasyonundan yeni bir kloz öğrenir. Böylece aynı yanlış koridora tekrar girmez. Yine de DPLL’yi anlamak kritiktir: birim yayılım, karar verme ve geri izleme fikri, bugünün güçlü çözücülerinin çalışan motorudur. NP-tamlık “her örnek zor” demek değildir; doğru temsil, akıllı yayılım ve öğrenme ile birçok gerçek problem gayet çözülebilir hale gelir.
Yorumlar