İçindekiler
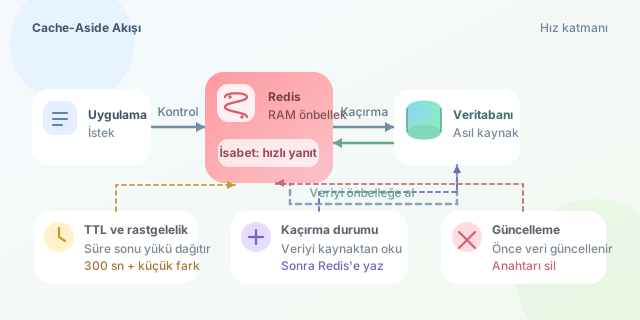
Bir uygulama büyüdükçe en pahalı sorgular genellikle veritabanına tekrar tekrar yapılan, sonucu nadiren değişen okumalardır. Ürün kataloğu, kullanıcı profili, popüler içerikler veya kur bilgileri buna iyi örneklerdir. Redis, bu verileri RAM üzerinde tutarak milisaniyeler seviyesinde yanıt üretir; böylece veritabanı yalnızca gerçekten gerektiğinde devreye girer.
``
Neden Redis?
Redis, anahtar-değer temelli, bellek içi bir veri deposudur. String, hash, list, set ve sorted set gibi yapıları desteklemesi onu yalnızca basit bir cache aracı olmaktan çıkarır. Disk tabanlı bir veritabanı sorgusunun gecikmesi ağ, indeks, disk erişimi ve sorgu planından etkilenirken Redis çoğu okumayı doğrudan bellekte tamamlar.
Önbelleğin temel kazancı, veritabanına giden istek sayısını azaltmasıdır. Örneğin isteklerin $N$ kadarı aynı veriyi talep ediyor ve önbellek isabet oranı $h$ ise veritabanına yaklaşık olarak şu kadar istek ulaşır:
\[N_{db} = N \times (1-h)\]$100.000$ istekte %95 isabet oranı, veritabanına yalnızca $5.000$ istek kalması demektir. Ancak cache hız sihri değil; güncellik, bellek kapasitesi ve hata senaryoları dikkatle tasarlanmalıdır.
| Kavram | Açıklama | Risk |
|---|---|---|
| Cache hit | Veri Redis’te bulunur | Eski veri dönebilir |
| Cache miss | Veri Redis’te yoktur | Veritabanına gidilir |
| TTL | Anahtarın yaşam süresi | Çok kısa ise hit oranı düşer |
| Invalidation | Eski veriyi silme | Yanlış yapılırsa tutarsızlık oluşur |
En yaygın desen: Cache-Aside
Cache-aside, uygulamanın önce Redis’i kontrol ettiği yaklaşımdır. Veri yoksa veritabanından okunur, Redis’e yazılır ve sonraki istekler hızlanır. Okuma yoğun sistemlerde en esnek ve en sık kullanılan stratejidir.
async function getProduct(id) {
  const key = `product:${id}`;
  const cached = await redis.get(key);

  if (cached) {
    return JSON.parse(cached);
  }

  const product = await db.products.findById(id);
  if (!product) return null;

  await redis.set(key, JSON.stringify(product), { EX: 300 });
  return product;
}
Bu örnekte EX: 300, ürün bilgisinin beş dakika yaşamasına izin verir. Güncelleme işleminde ilgili anahtarı silmek çoğu zaman yeterlidir:
async function updateProduct(id, data) {
  const product = await db.products.update(id, data);
  await redis.del(`product:${id}`);
  return product;
}
Bu yaklaşımda Redis, kalıcı veri kaynağı değil, hız katmanıdır. Asıl doğruluk otoritesi veritabanıdır.
TTL seçimi ve cache stampede
Her anahtara aynı TTL vermek beklenmedik bir soruna yol açabilir: Çok sayıda anahtar aynı anda sona ererse, binlerce istek aynı anda veritabanına yüklenir. Buna cache stampede denir. Çözüm olarak TTL değerine küçük bir rastgelelik eklenebilir.
const baseTtl = 300;
const jitter = Math.floor(Math.random() * 60);
await redis.set(key, value, { EX: baseTtl + jitter });
Ayrıca çok popüler ve üretimi pahalı veriler için kilit (lock) kullanılabilir. İlk istek veriyi üretirken diğer istekler kısa süre bekler veya eski cache değerini kullanır. Bu yaklaşım, ani trafik artışlarında veritabanını korur.
Stratejileri karşılaştırma
| Strateji | Yazma davranışı | En uygun senaryo |
|---|---|---|
| Cache-aside | Uygulama cache’i yönetir | Okuma ağırlıklı API’ler |
| Write-through | Önce cache ve veritabanı güncellenir | Güncelliğin önemli olduğu veriler |
| Write-behind | Önce cache, sonra asenkron kalıcılık | Çok yüksek yazma trafiği |
| Read-through | Cache sağlayıcısı eksik veriyi yükler | Altyapı soyutlaması istenen sistemler |
Write-through tutarlılığı artırır ama yazma gecikmesini büyütebilir. Write-behind ise hızlıdır; fakat kuyruk veya Redis arızasında henüz veritabanına aktarılmamış veri kaybı riski taşır.
Son olarak, her şeyi cache’lemek cazip görünse de doğru metrikler karar vermelidir: hit rate, Redis bellek kullanımı, anahtarların ortalama boyutu ve veritabanı gecikmesi düzenli izlenmelidir. İyi bir Redis stratejisi, en çok okunan veriyi akıllıca hızlandırır; veri tutarlılığını ise şansa bırakmaz.
Yorumlar