İçindekiler
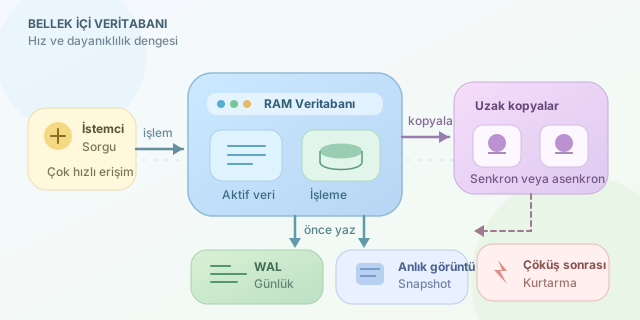
Bellek içi veritabanları, verileri klasik sistemlerdeki gibi sürekli diskten okumak yerine doğrudan RAM üzerinde işler. Böylece sorgular saniyenin küçük kesirlerinde tamamlanabilir. Ancak RAM uçucudur: Elektrik kesildiğinde içindeki veriler kaybolur. Dolayısıyla asıl mühendislik numarası yalnızca hızlı olmak değil, sistem çöktüğünde hafızasını geri kazanabilmektir.
``
Hızın fiziksel kaynağı
Bir veritabanının performansını anlamak için donanımın gecikme farklarına bakmalıyız. RAM’e erişim nanosaniyelerle, SSD erişimi ise mikrosaniyelerle ölçülür. Aradaki fark küçük görünse de milyonlarca işlemde devasa hâle gelir.
Basitleştirilmiş toplam sorgu süresi şöyle modellenebilir:
\[T_{toplam} = T_{erişim} + T_{işleme} + T_{bekleme}\]Bellek içi sistemler özellikle $T_{erişim}$ değerini küçültür. Ayrıca disk sayfalarını önbelleğe taşıma, sayfa değiştirme ve yoğun I/O kuyruğu gibi maliyetleri azaltır.
| Depolama katmanı | Yaklaşık gecikme | Elektrik kesilince durum | Tipik kullanım |
|---|---|---|---|
| CPU önbelleği | Nanosaniyeler | Kaybolur | Çok sıcak veriler |
| RAM | Onlarca nanosaniye | Kaybolur | Aktif veri kümesi |
| NVMe SSD | Onlarca mikrosaniye | Korunur | Kalıcı kayıtlar |
| HDD | Milisaniyeler | Korunur | Arşiv ve yedekleme |
RAM’in hızlı fakat unutkan olması, bu sistemleri biraz dâhi ama dalgın bir öğrenciye benzetir: Soruyu anında çözer, fakat not almazsa elektrik kesilince her şeyi unutur.
WAL: Önce günlüğe yaz
En yaygın güvenlik mekanizmalarından biri Write-Ahead Log, yani WAL’dır. Veritabanı bir değişikliği RAM’deki ana yapıya uygulamadan önce işlemi kalıcı bir günlüğe yazar. Çöküş sonrasında bu günlük yeniden oynatılır.
BEGIN tx=42
SET kullanici:7:bakiye 950
COMMIT tx=42
Burada COMMIT kaydı diske güvenli biçimde ulaştıysa işlem tamamlanmış kabul edilir. Yeniden başlatma sırasında BEGIN görülüp COMMIT görülmeyen işlemler yok sayılır. Böylece yarım kalmış güncellemeler veritabanını tutarsızlaştırmaz.
Güvenli onay süresi kabaca şöyledir:
\[T_{commit} = T_{log} + T_{flush} + T_{ack}\]Her işlemde diske senkron yazmak dayanıklılığı artırır, fakat hızı düşürür. Grup commit yaklaşımı ise birkaç işlemi tek disk yazımında birleştirerek bu maliyeti paylaşır.
Snapshot: RAM’in toplu fotoğrafı
WAL sürekli büyürse kurtarma sırasında milyonlarca kaydın yeniden oynatılması gerekir. Snapshot mekanizması belirli anlarda belleğin tutarlı görüntüsünü diske kaydeder. Kurtarma işlemi, en son snapshot’ı yükler ve yalnızca ondan sonraki günlük kayıtlarını uygular.
def recover(snapshot, wal):
    database = load_snapshot(snapshot)
    for record in wal:
        if record.committed:
            database.apply(record)
    return database
Bu sözde kod, kurtarmanın temel mantığını gösterir. Gerçek sistemlerde checksum doğrulaması, işlem sıralaması ve bozuk günlük parçalarının tespiti de gerekir.
| Strateji | Kurtarma hızı | Veri kaybı riski | Performans maliyeti |
|---|---|---|---|
| Yalnızca snapshot | Orta | Son snapshot sonrası yüksek | Düşük |
| Senkron WAL | Orta | Çok düşük | Yüksek |
| Snapshot + WAL | Yüksek | Çok düşük | Dengeli |
| Asenkron replikasyon | Yüksek | Son işlemler kaybolabilir | Düşük |
| Senkron replikasyon | Yüksek | Çok düşük | Ağ gecikmesi ekler |
Makine tamamen giderse ne olur?
Diskin de bozulduğu bir senaryoda yerel WAL yeterli değildir. Bu nedenle veriler başka düğümlere kopyalanır. Senkron replikasyonda ana düğüm, en az bir kopya işlemi doğrulamadan istemciye başarı cevabı vermez. Asenkron yöntemde cevap daha hızlıdır; ancak ana düğüm kopyalama tamamlanmadan çökerse birkaç son işlem kaybolabilir.
Sağlam bir mimari snapshot, WAL, replikasyon ve düzenli yedeklemeyi birlikte kullanır. Ayrıca kurtarma planı yalnızca belgelenmemeli, gerçekten test edilmelidir. Çünkü bir yedeğin var olmasıyla geri yüklenebilir olması aynı şey değildir. Bellek içi veritabanlarının gerçek başarısı, RAM’in süratini kalıcı depolamanın güvenilirliğiyle birleştirmelerinde yatar.
Yorumlar