İçindekiler
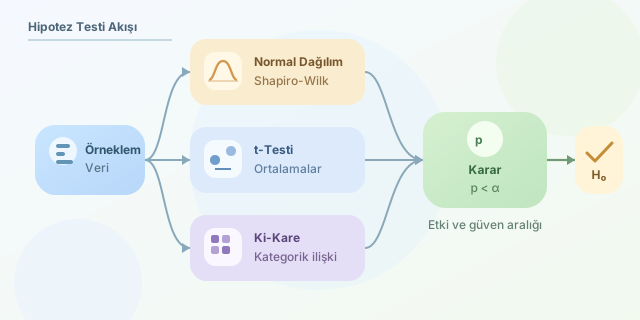
Veriyle çalışırken en heyecanlı soru şudur: Gördüğümüz fark gerçekten anlamlı mı, yoksa rastlantının küçük bir şakası mı? R, bu soruyu sistematik biçimde yanıtlamak için güçlü araçlar sunar. Normal dağılım varsayımını incelemek, ortalamaları t-testiyle karşılaştırmak ve kategorik ilişkileri ki-kare testiyle değerlendirmek; veri analistinin temel üçlüsüdür.
``
Bir hipotez testi, örneklemden yola çıkarak anakütle hakkında karar vermeye çalışır. Başlangıç noktası sıfır hipotezidir ($H_0$): genellikle fark, etki veya ilişki olmadığını savunur. Alternatif hipotez ($H_1$) ise araştırma iddiasını temsil eder. Test sonunda hesaplanan p-değeri, $H_0$ doğruyken gözlenen kadar uç bir sonucun ortaya çıkma olasılığıdır. Eğer $p < \alpha$ ise — yaygın olarak $\alpha=0.05$ seçilir — $H_0$ reddedilir.
Küçük p-değeri, etkinin büyük olduğu anlamına gelmez; yalnızca verinin sıfır hipoteziyle ne kadar uyumsuz olduğunu anlatır. Etki büyüklüğü ve güven aralığı da rapora eşlik etmelidir.
1. Normal dağılım: Varsayım kontrolü
Normal dağılım, ortalaması $\mu$ ve standart sapması $\sigma$ olan çan eğrisidir. Yoğunluk fonksiyonu şöyledir:
\[f(x)=\frac{1}{\sigma\sqrt{2\pi}}e^{-\frac{(x-\mu)^2}{2\sigma^2}}\]Özellikle klasik t-testlerinde verinin veya daha doğru ifadeyle grup içi artıkların yaklaşık normal olması beklenir. R’da hem görsel hem de sayısal kontrol yapmak akıllıcadır. Shapiro-Wilk testi için $H_0$: “veri normal dağılımdan gelmektedir” şeklindedir.
set.seed(42)
puanlar <- rnorm(40, mean = 72, sd = 8)

hist(puanlar, breaks = 10, col = "skyblue",
     main = "Puan Dağılımı", xlab = "Puan")
qqnorm(puanlar); qqline(puanlar, col = "red")
shapiro.test(puanlar)
Histogram genel şekli, Q-Q grafiği ise teorik normal kuantillerle gözlemleri karşılaştırır. Noktalar çizgiye yakınsa dağılım makul ölçüde normaldir. Shapiro-Wilk sonucu tek başına hüküm vermez: Büyük örneklemlerde minicik sapmalar bile anlamlı çıkabilir; küçük örneklemlerde ise testin gücü sınırlıdır.
| Araç | İncelediği şey | Pratik yorum |
|---|---|---|
| Histogram | Genel dağılım şekli | Çarpıklık ve aykırı değerleri gösterir |
| Q-Q grafiği | Normal kuantillere uyum | Çizgiden sistematik sapma önemlidir |
| Shapiro-Wilk | Normalite için p-değeri | $p < 0.05$ ise normalite sorgulanır |
2. t-testi: Ortalamalar sahnede
Tek örneklem t-testi, bir grubun ortalamasını bilinen bir değerle karşılaştırır. Test istatistiği:
\[t=\frac{\bar{x}-\mu_0}{s/\sqrt{n}}\]İki bağımsız grubun ortalamaları için ise grupların bağımsız olması gerekir. Varyanslar eşit değilse R’ın varsayılanı olan Welch t-testi güvenli bir tercihtir.
kontrol <- c(68, 72, 70, 75, 69, 71, 73, 67)
yeni_yontem <- c(74, 78, 76, 79, 73, 77, 80, 75)

sonuc <- t.test(yeni_yontem, kontrol,
                alternative = "two.sided",
                conf.level = 0.95)
print(sonuc)
Bu kod, yeni yöntemin ortalama puanının kontrol grubundan farklı olup olmadığını sınar. Çıktıdaki estimate ortalamaları, conf.int ortalama farkı için %95 güven aralığını, p-value ise karar için kanıtı verir. Güven aralığı sıfırı içermiyorsa iki yönlü testte sonuç genellikle anlamlıdır.
| Test türü | Ne zaman kullanılır? | R fonksiyonu |
|---|---|---|
| Tek örneklem t-testi | Ortalama bir hedef değerle karşılaştırılır | t.test(x, mu = 70) |
| Bağımsız iki örneklem | Farklı iki grubun ortalaması | t.test(x, y) |
| Eşleştirilmiş t-testi | Önce-sonra gibi bağlı ölçümler | t.test(x, y, paired = TRUE) |
3. Ki-kare testi: Kategoriler arasındaki ilişki
Ki-kare bağımsızlık testi, iki kategorik değişkenin ilişkili olup olmadığını araştırır. Beklenen frekanslar $E_{ij}$ ile gösterilirse istatistik şöyledir:
\[\chi^2=\sum\frac{(O_{ij}-E_{ij})^2}{E_{ij}}\]Örneğin üyelik türü ile satın alma kararının bağımsız olup olmadığını test edelim:
tablo <- matrix(c(42, 18, 30, 35), nrow = 2, byrow = TRUE,
                dimnames = list(Uyelik = c("Standart", "Premium"),
                                SatinAlma = c("Evet", "Hayir")))
chisq.test(tablo)
Ki-kare testinde gözlemler bağımsız olmalı ve beklenen hücre frekanslarının çoğu 5’in üzerinde kalmalıdır. Bu koşul bozulursa fisher.test(tablo) daha uygun olabilir. Sonuçları raporlarken test adı, istatistik, serbestlik derecesi, p-değeri, güven aralığı ve bağlamdaki pratik anlamı birlikte verin. R hesaplar; analitik hikâyeyi kurmak ise size kalır.
Yorumlar