İçindekiler
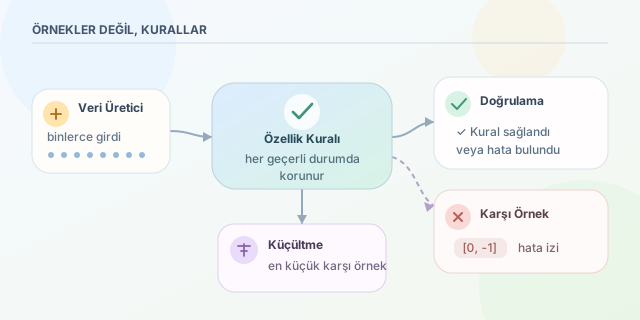
Geleneksel testlerde genellikle belirli bir girdi seçer, beklenen çıktıyı yazar ve sonucu karşılaştırırız. Peki seçmediğimiz binlerce girdi ne olacak? Property-Based Testing, birkaç mutlu örneğe güvenmek yerine yazılımın her geçerli durumda koruması gereken kuralları tanımlar. Test aracı da çok sayıda veri üreterek bu kuralları bozmaya çalışır; adeta kodumuza yaratıcı ve biraz da huysuz bir denetçi göndeririz. ``
Örnekten özelliğe geçiş
Bir toplama fonksiyonunu test ettiğimizi düşünelim. Klasik yaklaşımda topla(2, 3) == 5 gibi örnekler yazarız. Bu test doğrudur, fakat yalnızca seçtiğimiz iki sayıyla ilgili güvence verir. Property-Based Testing yaklaşımında ise toplamanın değişme özelliğini ifade ederiz:
Buradaki property, yani özellik, geniş bir girdi kümesi için doğru kalması gereken kuraldır. Test kütüphanesi negatif sayılar, sıfır, çok büyük değerler ve bizim aklımıza gelmeyen kombinasyonlar üretir.
| Yaklaşım | Test edilen şey | Güçlü yanı | Zayıf yanı |
|---|---|---|---|
| Örnek tabanlı test | Belirli girdi ve çıktılar | Okunması ve hata ayıklaması kolaydır | Kenar durumları unutulabilir |
| Property-Based Testing | Genel davranış kuralları | Geniş veri uzayını tarar | Doğru property’yi bulmak emek ister |
| Rastgele test | Kontrolsüz rastgele girdiler | Beklenmedik değerler üretir | Sonucun doğruluğunu belirlemek zor olabilir |
Python ve Hypothesis ile ilk test
Python dünyasında bu yaklaşım için en popüler araçlardan biri Hypothesis kütüphanesidir. Aşağıdaki test, listeyi iki kez ters çevirmenin başlangıçtaki listeyi vermesi gerektiğini doğrular:
from hypothesis import given
from hypothesis import strategies as st

@given(st.lists(st.integers()))
def test_iki_kez_ters_cevirme(liste):
    sonuc = list(reversed(list(reversed(liste))))
    assert sonuc == liste
@given, test için veri üretileceğini belirtir. st.lists(st.integers()) ise farklı uzunluklarda ve farklı tamsayılar içeren listeler oluşturur. Böylece boş liste, tek elemanlı liste ve sıra dışı sayılar ayrıca yazılmadan sınanır.
Üretilen test sayısı $n$, her testin hata bulma olasılığı $p$ ise en az bir hata yakalama olasılığı yaklaşık olarak şöyledir:
\[P(\text{hata}) = 1 - (1-p)^n\]Bu ifade, daha fazla denemenin neden yararlı olduğunu gösterir; ancak çok sayıda kötü test, iyi tanımlanmış tek bir property’nin yerini tutmaz.
Güçlü property türleri
En kullanışlı kurallardan biri round-trip özelliğidir. Bir veriyi kodlayıp geri çözdüğümüzde aynı değeri elde etmeliyiz:
@given(st.text())
def test_utf8_round_trip(metin):
    kodlanmis = metin.encode("utf-8")
    cozulmus = kodlanmis.decode("utf-8")
    assert cozulmus == metin
Başka bir teknik invariant kontrolüdür. Örneğin sıralama sonrasında eleman sayısı ve elemanların kendileri değişmemelidir. Idempotence ise aynı işlemin tekrar uygulanmasının sonucu değiştirmemesidir: normalize(normalize(x)) == normalize(x).
Shrinking: Hatanın diyet programı
Property-Based Testing araçlarının en etkileyici özelliklerinden biri shrinking işlemidir. Araç bir hata bulduğunda devasa ve karmaşık girdiyi doğrudan önümüze bırakmaz. Aynı hatayı oluşturan daha küçük girdileri sistematik biçimde arar.
Örneğin hata 200 elemanlı bir listede ortaya çıktıysa Hypothesis bunu [0, -1] gibi küçük bir karşı örneğe indirgeyebilir. Küçük karşı örnek, problemin asıl nedenini görmeyi ve testi daha sonra anlamayı kolaylaştırır.
Her şeyi property ile mi test etmeliyiz?
Hayır. Sabit iş kuralları, bilinen regresyonlar ve kullanıcı arayüzü ayrıntıları çoğu zaman örnek tabanlı testlerle daha açık anlatılır. En iyi strateji iki yaklaşımı birlikte kullanmaktır: Örnek testler önemli senaryoları belgelerken property testleri görünmeyen boşlukları araştırır.
İyi bir başlangıç için fonksiyonunuza şu soruları sorun: İşlem tersine çevrilebilir mi? Çıktının boyutu hakkında ne biliyorum? Sıralama, tekrar uygulama veya girdi sırası sonucu etkilemeli mi? Bu soruların cevapları, kodun gerçek sözleşmesini ortaya çıkarır. Sonuçta mesele binlerce örnek yazmak değil; binlerce örneği yöneten birkaç güçlü kuralı keşfetmektir.
Yorumlar