İçindekiler
Paralel programlama, bir işi birden fazla çalışana paylaştırmak gibidir: Doğru koordinasyonla işler hızlanır, koordinasyon yoksa herkes aynı dosyanın üzerine kahve döker. Veri yarışı (data race), birden fazla iş parçacığının aynı bellek konumuna eş zamanlı erişmesi, erişimlerden en az birinin yazma olması ve aralarında uygun bir senkronizasyon bulunmaması durumudur. Sonuç; bazen çalışan, bazen bozulan ve hata ayıklayıcı açılınca mucizevi biçimde düzelen programlardır. ``
Sorun neden ortaya çıkar?
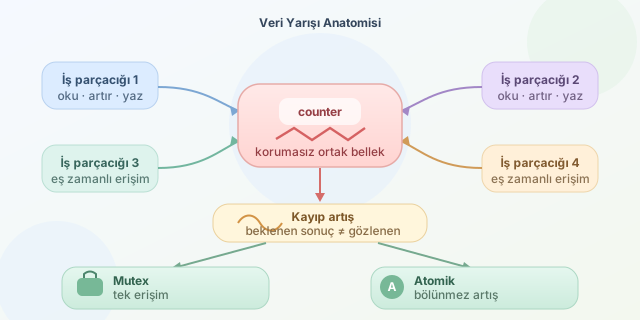
İki thread’in ortak bir counter değişkenini artırdığını düşünelim. Kaynak kodda counter++ tek işlem gibi görünse de işlemci açısından genellikle üç aşamadır:
- Değeri bellekten veya önbellekten oku.
- Değeri bir artır.
- Sonucu geri yaz.
İki thread aynı değeri okuyup kendi sonucunu yazarsa artışlardan biri kaybolabilir. Her thread sayacı $N$ kez artırıyorsa ve thread sayısı $T$ ise beklenen sonuç:
\[C_{beklenen} = N \times T\]Ancak veri yarışı yüzünden gözlenen değer çoğunlukla şu aralıkta gezinir:
\[C_{gözlenen} \leq C_{beklenen}\]Üstelik mesele yalnızca komutların sırası değildir. Derleyici optimizasyonları, CPU önbellekleri ve işlemci tarafından yapılan komut yeniden sıralamaları da davranışı etkiler.
Küçük ama tehlikeli bir örnek
Aşağıdaki C++ programında dört thread aynı sayacı korumasız biçimde artırır:
#include <iostream>
#include <thread>
#include <vector>

int counter = 0;

void increment() {
    for (int i = 0; i < 100000; ++i) {
        ++counter; // Atomik değildir: oku, artır, yaz
    }
}

int main() {
    std::vector<std::thread> threads;

    for (int i = 0; i < 4; ++i)
        threads.emplace_back(increment);

    for (auto& thread : threads)
        thread.join();

    std::cout << counter << '\n';
}
Matematiksel olarak sonuç 400000 olmalıdır. Buna rağmen program farklı çalıştırmalarda farklı değerler yazdırabilir. C++ bellek modelinde bu durum yalnızca “yanlış sonuç” değildir; tanımsız davranıştır. Derleyici, böyle bir yarışın bulunmadığını varsayarak beklenmedik optimizasyonlar yapabilir.
Data race ve race condition aynı mı?
| Kavram | Tanım | Ortak bellek şart mı? | Sonuç |
|---|---|---|---|
| Data race | Senkronize edilmemiş çakışan bellek erişimleri | Evet | Tanımsız veya rastgele davranış |
| Race condition | Sonucun olayların zamanlama sırasına bağlı olması | Hayır | Mantıksal hata |
| Deadlock | Thread’lerin birbirini sonsuza kadar beklemesi | Hayır | Program ilerleyemez |
Her data race bir yarış problemidir; fakat her race condition data race değildir. Örneğin iki ağ isteğinin farklı sıralarda tamamlanması ortak belleğe erişmeden de mantıksal yarış oluşturabilir.
Mutex ile güvenli çözüm
Paylaşılan veriye aynı anda yalnızca bir thread’in erişmesini sağlamak için std::mutex kullanılabilir:
#include <mutex>

int counter = 0;
std::mutex counterMutex;

void increment() {
    for (int i = 0; i < 100000; ++i) {
        std::lock_guard<std::mutex> lock(counterMutex);
        ++counter;
    }
}
std::lock_guard, kapsam başladığında kilidi alır ve kapsam bittiğinde otomatik bırakır. Böylece erken return veya istisna durumlarında kilidin unutulması önlenir.
Basit sayaçlarda daha hafif bir seçenek std::atomic kullanmaktır:
#include <atomic>

std::atomic<int> counter{0};

void increment() {
    for (int i = 0; i < 100000; ++i)
        counter.fetch_add(1, std::memory_order_relaxed);
}
memory_order_relaxed, artışın atomik olmasını sağlar; ancak başka veriler arasında sıralama garantisi vermez. Bu nedenle karmaşık durumlarda bellek sıralamasını bilinçsizce gevşetmek yeni hayaletler çağırabilir.
Nasıl yakalanır?
Gözle inceleme her zaman yeterli değildir. GCC veya Clang ile ThreadSanitizer kullanılabilir:
g++ -std=c++20 -fsanitize=thread -g main.cpp -pthread
./a.out
Araç, çakışan erişimleri ve ilgili thread’leri raporlar. Yine de en güçlü savunma iyi tasarımdır: değiştirilebilir ortak veriyi azaltmak, sahipliği açıkça belirlemek, mesajlaşmayı tercih etmek ve senkronizasyon politikasını belgelemek. Paralel kodda “bende çalıştı” bir başarı ölçütü değil, yaklaşan fırtınanın sessizliğidir.
Yorumlar