İçindekiler
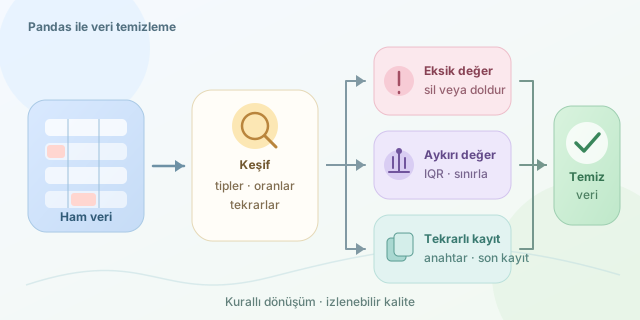
Gerçek hayattaki veri setleri nadiren analiz edilmeye hazır gelir: bazı hücreler boş, bazı ölçümler fizik kurallarına meydan okuyacak kadar uç, bazı satırlar ise aynı bilgiyi tekrar tekrar taşır. Pandas ile veri temizleme; veriyi körü körüne silmek değil, veri kalitesini ölçüp iş problemine uygun dönüşümler uygulamaktır. Amaç, modelin ve raporların sinyal yerine gürültü öğrenmesini engellemektir. ``
Önce keşif: Sorun nerede?
Temizliğe başlamadan önce veri tiplerini, boşluk oranlarını ve tekrarları incelemek gerekir. Bir sütundaki eksik oranı şu şekilde ifade edilir: $r = \frac{n_{eksik}}{n_{toplam}}$. Ancak bu oran tek başına karar verdirmez; örneğin kritik bir müşteri kimliğinde %1 eksik bile ciddi olabilir.
import pandas as pd

# Örnek veri setini yükleyelim
df = pd.read_csv("satislar.csv")

print(df.info())
print(df.isna().sum())
print("Tekrarlı satır:", df.duplicated().sum())
print(df.describe(include="all"))
info() veri türü sürprizlerini, isna() eksikleri, describe() ise özellikle sayısal sütunlardaki şüpheli minimum ve maksimumları görünür kılar. Örneğin yaş sütununda 999 görmek, veri girişinde küçük bir felaket yaşandığını haber verir.
Eksik değerler: Silmek mi, doldurmak mı?
Eksik değerler her zaman aynı anlama gelmez. Ölçüm yapılamamış olabilir, kullanıcı alanı atlamış olabilir ya da değer özellikle paylaşılmamış olabilir. Bu nedenle önce eksikliğin mekanizmasını düşünün: rastgele eksiklik (MCAR), gözlenen başka bir değişkene bağlı eksiklik (MAR) veya değerin kendisine bağlı eksiklik (MNAR).
| Yöntem | Ne zaman uygun? | Risk |
|---|---|---|
dropna() |
Çok az sayıda ve önemsiz eksik varsa | Değerli satırları kaybetmek |
| Ortalama/medyan | Sayısal dağılım makulse | Varyansı yapay biçimde azaltmak |
| Mod | Kategorik sütunlarda | Baskın sınıf yanlılığı |
| Grup bazlı doldurma | Bölge, ürün gibi bağlam varsa | Yanlış gruplama |
# Kritik alanları boş olan kayıtları çıkar
df = df.dropna(subset=["musteri_id", "satis_tarihi"])

# Aykırı değerlere daha dayanıklı olduğu için medyan kullan
df["gelir"] = df["gelir"].fillna(df["gelir"].median())

# Her şehir için kendi yaş medyanı ile doldur
df["yas"] = df["yas"].fillna(
    df.groupby("sehir")["yas"].transform("median")
)
Medyanın avantajı nettir: ortalama uç değerlerden fazla etkilenirken medyan sıralamadaki orta noktayı korur. Ayrıca doldurma yapılmış satırları izlemek için gelir_eksikti = df['gelir'].isna() gibi bir bayrağı dönüşümden önce oluşturmak iyi bir pratiktir.
Aykırı değerler: Her uç değer hata değildir
Aykırı değer, mutlaka silinecek yanlış kayıt demek değildir. Çok yüksek tutarlı bir satış, VIP müşteriyi temsil edebilir. Yaygın bir yaklaşım IQR yöntemidir: $IQR = Q_3 - Q_1$. Alt ve üst sınırlar sırasıyla $Q_1 - 1.5 \times IQR$ ve $Q_3 + 1.5 \times IQR$ olarak hesaplanır.
q1 = df["satis_tutari"].quantile(0.25)
q3 = df["satis_tutari"].quantile(0.75)
iqr = q3 - q1
alt_sinir = q1 - 1.5 * iqr
ust_sinir = q3 + 1.5 * iqr

# Silmek yerine sınırlar içinde tut: winsorization benzeri yaklaşım
df["satis_tutari"] = df["satis_tutari"].clip(alt_sinir, ust_sinir)
clip() özellikle tahminleme süreçlerinde satır sayısını korur. Buna karşılık açıkça imkânsız değerler, örneğin negatif adetler, iş kuralıyla doğrudan filtrelenmelidir.
Tekrarlı kayıtlar: Aynı satır mı, aynı olay mı?
Tam satır tekrarları drop_duplicates() ile temizlenebilir. Fakat müşteri kimliği ve tarih aynı olan iki kayıt, gerçekten tekrar mı yoksa iki ayrı işlem mi sorusunu gerektirir. Bu yüzden tekrar anahtarını iş bağlamına göre seçin.
# Birebir aynı satırları kaldır
df = df.drop_duplicates()

# Aynı müşteri ve sipariş numarası için son güncellemeyi koru
df = df.sort_values("guncelleme_tarihi")
df = df.drop_duplicates(subset=["musteri_id", "siparis_no"], keep="last")

# Son kontrol
print(df.isna().mean().sort_values(ascending=False))
print(df.shape)
Temiz veri, “hiç eksik olmayan veri” değildir; dönüşümleri belgelenmiş, kuralları test edilmiş ve analiz amacına uygun veridir. Orijinal dosyayı koruyun, her adımın öncesi-sonrası satır sayılarını kaydedin ve temizleme kararlarını veri sözlüğünde açıklayın. Böylece Pandas betiğiniz sadece temizlik yapmaz; denetlenebilir bir veri hikâyesi de üretir.
Yorumlar