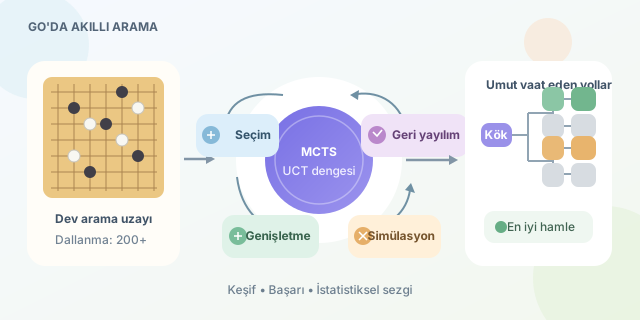
Go, kuralları birkaç dakikada öğrenilebilen fakat ustalaşması yıllar süren bir oyundur. 19×19’luk tahtada ilk hamlede yüzlerce seçenek bulunur; oyun ilerledikçe olası hamle dizileri astronomik boyutlara ulaşır. Bu yüzden satrançtaki gibi tüm hamleleri derinlemesine hesaplayıp değerlendiren klasik minimax yaklaşımı, Go için tek başına yeterince pratik değildir. Monte Carlo Ağaç Araması (MCTS), ağacın umut vaat eden bölgelerini rastgele ama kontrollü simülasyonlarla keşfederek bu probleme zarif bir cevap verir.
``
Neden Go araması zor?
Satrançta ortalama dallanma faktörü yaklaşık 30–35 iken, Go’da bu sayı çoğu konumda 200’ün üstüne çıkabilir. Bir oyunun ortalama uzunluğunu $d$, her pozisyondaki ortalama yasal hamle sayısını da $b$ kabul edersek, kaba arama uzayı $b^d$ ile büyür. Bu üstel büyüme, küçük görünen farkları bile devasa hâle getirir.
| Özellik | Satranç | Go (19×19) |
|---|---|---|
| Ortalama dallanma faktörü | 30–35 | 200+ |
| Konumsal değerlendirme | Görece belirgin | Çok karmaşık |
| Tahta durumu | Taşların rolü belirgin | Bağlantı, etki ve alan kritik |
| Tam genişlikte arama | Kısmen uygulanabilir | Pratikte imkânsız |
Go’da bir taşın değeri sabit değildir: Bir grup canlı mı, çevreleniyor mu, gelecekte alan kazanacak mı? Bu soruların yanıtı çoğu zaman oyunun çok ilerisine bağlıdır. MCTS’nin ana fikri tam da burada parlar: Her şeyi hesaplamak yerine, örnekle.
MCTS’nin dört aşamalı döngüsü
MCTS, her iterasyonda kökten başlayarak dört işlem yapar: seçim, genişletme, simülasyon ve geri yayılım. Binlerce ya da milyonlarca tekrar sonunda ağaç, iyi hamleler hakkında istatistiksel kanıt toplamış olur.
- Seçim: Ağaçta daha önce açılmış düğümler arasında dengeli bir tercih yapılır.
- Genişletme: Henüz denenmemiş bir hamle, ağaca yeni düğüm olarak eklenir.
- Simülasyon: Bu konumdan oyun sonuna kadar hızlı bir deneme oyunu oynanır.
- Geri yayılım: Sonuç, ziyaret edilen tüm düğümlerin galibiyet ve ziyaret sayılarına işlenir.
Seçim aşamasında yaygın kullanılan UCT formülü şöyledir:
\[UCT_i = \frac{W_i}{N_i} + c\sqrt{\frac{\ln N_p}{N_i}}\]Burada $W_i$ kazanılan oyun sayısı, $N_i$ çocuğun ziyaret sayısı, $N_p$ ebeveynin ziyaret sayısıdır. İlk terim sömürüdür: Başarılı hamleleri seçer. İkinci terim keşiftir: Az denenmiş hamlelere şans tanır. $c$ parametresi bu iki dürtü arasındaki dengeyi belirler. Kısacası algoritma, “iyi görünen yolu sürdür ama sürpriz ihtimallerini tamamen unutma” der.
Basitleştirilmiş Python iskeleti
Aşağıdaki örnek, UCT seçimini ve sonuçların geri yayılımını gösterir. Gerçek bir Go motorunda legal_moves, play ve is_terminal işlevleri tahta kurallarıyla doldurulur.
import math

class Node:
    def __init__(self, state, parent=None):
        self.state = state
        self.parent = parent
        self.children = []
        self.wins = 0
        self.visits = 0

    def uct_score(self, child, c=1.41):
        if child.visits == 0:
            return float("inf")
        exploit = child.wins / child.visits
        explore = c * math.sqrt(math.log(self.visits) / child.visits)
        return exploit + explore

    def best_child(self):
        return max(self.children, key=lambda ch: self.uct_score(ch))

    def backpropagate(self, result):
        node = self
        while node:
            node.visits += 1
            node.wins += result
            node = node.parent
Bu kodda ziyaret edilmemiş çocuklara sonsuz puan verilmesi önemlidir: Algoritma önce her hamleyi en az bir kez görmeye çalışır. backpropagate, bir playout sonucunu köke kadar taşıyarak sonraki kararların daha bilgili alınmasını sağlar.
| Yaklaşım | Güçlü yanı | Sınırlaması |
|---|---|---|
| Minimax + alfa-beta | Taktik hesapta güçlü | Go’da dallanma patlaması |
| Saf rastgele playout | Çok hızlı | Stratejik olarak gürültülü |
| MCTS + UCT | Keşif ve başarı dengesı | Çok sayıda simülasyon ister |
| MCTS + sinir ağı | Yüksek oyun gücü | Eğitim verisi ve donanım maliyeti |
Modern sistemler, özellikle AlphaGo’nun gösterdiği gibi, MCTS’yi politika ve değer sinir ağlarıyla birleştirir. Politika ağı hangi hamlelerin umut verici olduğunu söyler; değer ağı ise oyunu sonuna kadar oynamadan konumun olası sonucunu tahmin eder. Böylece rastgelelik, kör bir zar atma işlemi olmaktan çıkar; istatistik, sezgi ve arama birlikte çalışan güçlü bir karar makinesine dönüşür.
Yorumlar