Bir dizideki çok sayıda aralık sorgusuna cevap vermek, ilk bakışta masum görünür: Her sorgu için ilgili aralığı dolaşır, sonucu hesaplar ve devam edersiniz. Ancak $N=Q=10^5$ olduğunda, her sorguyu tek tek taramak yaklaşık $O(NQ)$ maliyet üretir. İşte Mo Algoritması tam burada sahneye çıkar: Sorguları akıllıca yeniden sıralayarak, önceki sorgudan elde edilen bilgiyi mümkün olduğunca korur.
``
Mo Algoritması, çevrimdışı (offline) sorgu algoritmasıdır. Bunun anlamı önemlidir: Tüm sorgular en baştan bilinmelidir. Sorguların cevapları anlık olarak isteniyorsa veya arada dizi güncelleniyorsa, klasik sürümü doğrudan uygun olmayabilir. Buna karşılık yalnızca [L, R] aralıkları için; farklı eleman sayısı, en sık görülen değerin frekansı, frekansların karesi toplamı ya da belirli bir özelliği taşıyan eleman sayısı gibi sonuçlarda çok etkilidir.
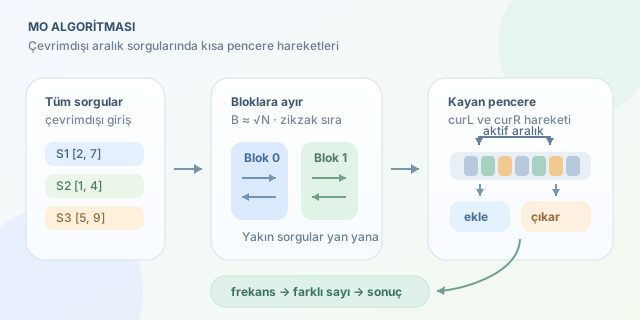
Temel fikir, sorguları sol uçlarına göre bloklara ayırmaktır. Blok boyutu genellikle $B \approx \sqrt{N}$ seçilir. Aynı bloktaki sorgular sağ uçlarına göre sıralanır. Böylece işaretçilerimiz olan curL ve curR, bir sorgudan diğerine zıplamak yerine kısa mesafeler kat eder. Yeni aralığa geçerken yalnızca aralığa giren veya çıkan elemanları add ve remove fonksiyonlarıyla işleriz.
| Yaklaşım | Sorgu başına maliyet | Toplam maliyet | Ne zaman tercih edilir? |
|---|---|---|---|
| Doğrudan tarama | $O(N)$ | $O(NQ)$ | Küçük veri kümeleri |
| Prefix sum | $O(1)$ | $O(N+Q)$ | Toplam gibi tersinir işlemler |
| Mo Algoritması | Amortize hareket maliyeti | $O((N+Q)\sqrt{N})$ | Karmaşık, statik aralık istatistikleri |
Örneğin her aralıkta kaç farklı sayı olduğunu bulalım. freq[x], değerin güncel penceredeki frekansını; distinct, frekansı sıfırdan büyük değerlerin sayısını tutsun. Bir değer ilk kez eklenirse distinct artar. Son kopyası çıkarılırsa azalır. Bu küçük kural, sorgu sonucunu her işaretçi hareketinde $O(1)$ güncel tutar.
struct Query {
    int l, r, id;
};

int blockSize;
bool compare(const Query& a, const Query& b) {
    int blockA = a.l / blockSize;
    int blockB = b.l / blockSize;
    if (blockA != blockB) return blockA < blockB;
    // Zigzag sıralama, sağ işaretçinin gereksiz dönüşünü azaltır.
    return (blockA & 1) ? a.r > b.r : a.r < b.r;
}

vector<int> moDistinct(vector<int>& a, vector<Query> queries) {
    int n = a.size();
    blockSize = max(1, (int)sqrt(n));
    sort(queries.begin(), queries.end(), compare);

    vector<int> freq(100001, 0), answer(queries.size());
    int curL = 0, curR = -1, distinct = 0;

    auto add = [&](int index) {
        if (freq[a[index]]++ == 0) distinct++;
    };
    auto remove = [&](int index) {
        if (--freq[a[index]] == 0) distinct--;
    };

    for (const auto& q : queries) {
        while (curL > q.l) add(--curL);
        while (curR < q.r) add(++curR);
        while (curL < q.l) remove(curL++);
        while (curR > q.r) remove(curR--);
        answer[q.id] = distinct;
    }
    return answer;
}
Kodda sorguların id alanı kritik bir ayrıntıdır. Mo Algoritması sorguları cevap sırasına göre değil, hareket maliyetini azaltacak sırada işler. Bu nedenle sonuçları orijinal kullanıcı sırasına geri koymak için kimlik saklanır. Ayrıca değerler çok büyük veya negatifse, freq dizisi yerine koordinat sıkıştırma uygulamak gerekir.
Karmaşıklığın sezgisi şöyledir: Yaklaşık $\sqrt{N}$ blok vardır. Sol işaretçi blok değişimlerinde sınırlı hareket eder; sağ işaretçi ise blok içindeki sıralama sayesinde kontrollü ilerler. Sonuçta yaygın üst sınır $O((N+Q)\sqrt{N})$ olur. Sabit çarpanlar önemlidir; bu yüzden add ve remove fonksiyonlarını olabildiğince hafif yazmak gerekir.
| Durum | Mo Algoritması uygun mu? | Sebep |
|---|---|---|
| Statik dizi, farklı eleman sayısı | Evet | Ekleyip çıkarma işlemleri kolaydır |
| Aralık toplamı | Genellikle hayır | Prefix sum daha hızlıdır |
| Nokta güncellemeleri de var | Dikkatli kullanılmalı | Zaman boyutlu Mo gerekir |
| Sorgular çevrimiçi geliyor | Hayır | Sıralama için tüm sorgular gerekir |
Özetle Mo Algoritması, tek tek sorguları hızlandırmaktan çok, sorgular arasındaki geçişi ucuzlatır. Bu bakış açısını kavradığınızda, aralık problemlerinde yalnızca sonucu değil, pencerenin nasıl evrildiğini de düşünmeye başlarsınız.
Yorumlar