Bir büyük dil modelini, her soruya cevap vermek için şirketin tüm çalışanlarını aynı toplantıya çağıran bir kurum gibi düşünebilirsiniz. Herkes katılır, herkes hesap yapar; fakat bu hem pahalı hem de yavaştır. Mixture of Experts (MoE) yaklaşımı ise doğru soruyu doğru uzman ekibe yönlendirir. Böylece model, çok büyük bir bilgi kapasitesine sahipken her kelime üretiminde bu kapasitenin yalnızca ilgili bölümünü çalıştırır. ``
Klasik yoğun (dense) Transformer modellerinde bir katmandaki tüm parametreler, her token için aktiftir. Örneğin 70 milyar parametreli bir modelin ileri yayılımı sırasında, mimarinin izin verdiği ölçüde tüm katmanları hesaplamaya katılır. MoE’de ise özellikle beslemeli ağ (FFN) katmanı, birden fazla uzman alt ağa bölünür. Bir router ya da kapılama (gating) ağı, gelen token’ın hangi uzmanlara gideceğine karar verir.
Temel fikir şöyle ifade edilebilir. Girdi temsili $x$ için $E$ adet uzmanımız olsun. Router, her uzman için bir skor üretir ve softmax ile olasılığa dönüştürür:
\[p(e \mid x) = \operatorname{softmax}(W_r x)_e\]Ancak bütün uzmanları çağırmak MoE’nin amacına ters düşer. Bu nedenle genellikle en yüksek skora sahip $k$ uzman seçilir. Çıktı yaklaşık olarak şu ağırlıklı toplamdır:
\[y = \sum_{e \in \operatorname{TopK}(p, k)} p(e \mid x) \cdot f_e(x)\]Burada $f_e(x)$, seçilen uzmanın dönüşümüdür. Yaygın bir yapı olan top-2 routing, her token’ı yalnızca iki uzmana yollar. Modelin toplam parametre sayısı devasa olabilir; fakat token başına etkin parametre sayısı daha sınırlı kalır. İşte “neden her parametre aynı anda kullanılmıyor?” sorusunun kısa cevabı budur: Hesaplama maliyetini patlatmadan kapasiteyi büyütmek.
| Özellik | Dense model | MoE model |
|---|---|---|
| Token başına aktivasyon | Tüm ilgili katmanlar | Seçili uzmanlar |
| Toplam kapasite | Parametreyle birlikte maliyet artar | Çok yüksek olabilir |
| Hesaplama maliyeti | Daha öngörülebilir | Router ve iletişime bağlı |
| Uzmanlaşma | Örtük olarak gelişir | Açık rota seçimiyle teşvik edilir |
| Ana risk | Büyük modelin pahalı olması | Dengesiz uzman kullanımı |
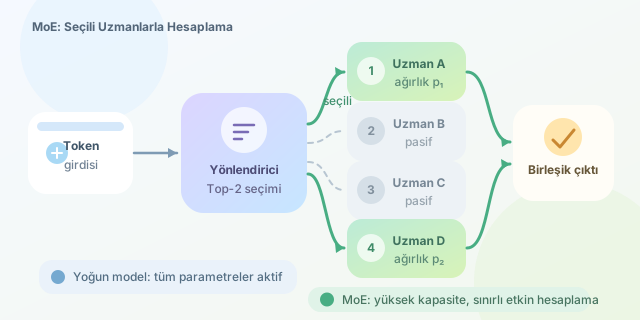
MoE’nin önemli bir ayrıntısı, uzmanların kendi kendine kusursuz iş bölümü yapmamasıdır. Router sürekli aynı birkaç uzmanı seçerse, onlar aşırı yüklenir; diğerleri ise adeta ofiste kahve içip bekler. Eğitim sırasında bu sorunu azaltmak için yük dengeleme kaybı eklenir. Amaç, token trafiğinin uzmanlar arasında makul biçimde dağılmasıdır. Ayrıca her uzmana bir kapasite sınırı konabilir; sınırı aşan token’lar başka bir uzmana yönlendirilir veya geçici olarak düşürülür.
Aşağıdaki sadeleştirilmiş PyTorch benzeri örnek, top-2 yönlendirme mantığını gösterir:
import torch
import torch.nn as nn

class SimpleMoE(nn.Module):
    def __init__(self, hidden_size, num_experts=8, top_k=2):
        super().__init__()
        self.router = nn.Linear(hidden_size, num_experts)
        self.experts = nn.ModuleList([
            nn.Sequential(nn.Linear(hidden_size, hidden_size * 4),
                          nn.GELU(),
                          nn.Linear(hidden_size * 4, hidden_size))
            for _ in range(num_experts)
        ])
        self.top_k = top_k

    def forward(self, x):
        scores = torch.softmax(self.router(x), dim=-1)
        weights, indices = scores.topk(self.top_k, dim=-1)
        output = torch.zeros_like(x)
        for rank in range(self.top_k):
            for expert_id, expert in enumerate(self.experts):
                mask = indices[..., rank] == expert_id
                output[mask] += weights[mask, rank].unsqueeze(-1) * expert(x[mask])
        return output
Gerçek üretim sistemleri bu çift döngüden çok daha verimlidir: Token’ları uzmanlara göre gruplayıp GPU’lar arasında taşırlar. Asıl zorluk da burada başlar. MoE, daha az aktif hesaplama sunsa da dağıtık sistemlerdeki ağ iletişimi, bellek yerleşimi ve yük dengesi gecikme yaratabilir.
Sonuç olarak MoE, “daha büyük model” hedefini “her seferinde daha çok hesaplama” zorunluluğundan ayırır. Bir matematik sorusunu sayısal uzmana, kod tamamlama isteğini programlama uzmanına yönlendiren görünmez bir santral gibidir. Doğru router, dengeli uzmanlar ve güçlü dağıtık altyapı birleştiğinde MoE, büyük dil modellerini hem daha kapasiteli hem de pratikte daha ekonomik hâle getirir.
Yorumlar