Bir sözlüğün tüm kelimeleri, bir derleyicinin anahtar sözcükleri ya da bir servisin değişmeyen kimlik listesi için hızlı arama yapmak istediğinizi düşünün. Klasik hash tabloları güçlüdür; ancak çakışmalar, boş kovalar ve ek bellek maliyeti taşırlar. Veri kümesi oluşturulduktan sonra değişmeyecekse Minimal Perfect Hash Function (MPHF), her anahtarı çakışmasız biçimde tam gereken indeks aralığına yerleştirerek bu maliyeti dramatik biçimde azaltır. ``
Önce: perfect ve minimal ne demek?
Elimizde $n$ farklı anahtardan oluşan sabit bir küme $S$ olsun. Bir hash fonksiyonu $h$, iki farklı anahtarın aynı çıktıya düşmemesini sağlıyorsa perfect hash fonksiyonudur:
\[\forall x, y \in S,\; x \neq y \Rightarrow h(x) \neq h(y)\]Fonksiyonun çıktı uzayı anahtar sayısıyla tam olarak aynıysa, yani $h: S \rightarrow {0,1,\ldots,n-1}$ biçimindeyse, fonksiyon ayrıca minimaldır. Bu durumda hiçbir indeks boşa gitmez. İdeal dünyadaki yerleşim oranı şöyledir:
\[\text{Doluluk oranı} = \frac{n}{n} = 1\]Buradaki kritik ayrım şudur: MPHF yalnızca anahtarların küme üyeliğini veya konumunu verir. Rastgele bir anahtar için yine $0$ ile $n-1$ arasında bir sayı döndürebilir. Bu nedenle gerçek üyelik doğrulaması gerekiyorsa anahtarı, parmak izini (fingerprint) ya da imzayı ayrıca saklamak gerekir.
| Özellik | Klasik hash tablosu | Minimal perfect hash |
|---|---|---|
| Veri güncelleme | Kolay | Genellikle yeniden inşa gerekir |
| Çakışma çözümü | Zincirleme veya açık adresleme | Sabit kümede yok |
| Boş alan | Sıklıkla vardır | Yok |
| Arama maliyeti | Ortalama $O(1)$ | $O(1)$ |
| En uygun kullanım | Dinamik veriler | Salt-okunur veriler |
Nasıl inşa edilir?
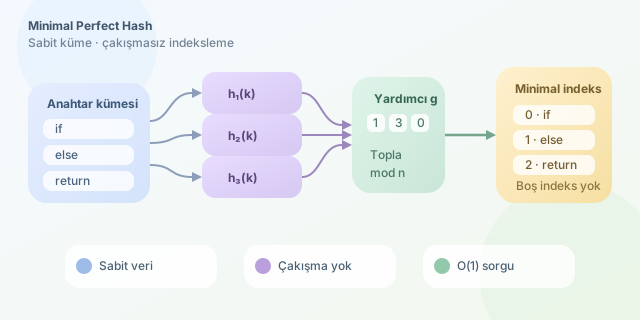
MPHF üretmek, normal bir hash çağrısından daha karmaşıktır. Yaygın yaklaşım, anahtarları birden fazla hash fonksiyonuyla hipergrafın kenarları gibi modellemektir. Eğer grafik uygun biçimde “soyulabiliyorsa”, her anahtarın hedef indeksi için küçük yönlendirme değerleri hesaplanabilir. BDZ ve CHD, bu fikrin popüler ailelerindendir.
Basitleştirilmiş bir şemada üç hash değeri hesaplanır ve yardımcı dizi üzerinden sonuç elde edilir:
\[h(k) = (g[h_1(k)] + g[h_2(k)] + g[h_3(k)]) \bmod n\]Buradaki $g$ dizisi inşa aşamasında ayarlanır. Amaç, kümedeki her anahtar için sonuçların farklı olmasını sağlamaktır. İnşa süreci rastgele tohumlarla birkaç kez deneyebilir; buna karşın sorgu tarafı son derece hızlı ve deterministiktir.
Aşağıdaki Python örneği gerçek bir MPHF üreticisi değildir; mantığı göstermek için önceden hazırlanmış yardımcı tabloyu kullanır. Üretim ortamında bbhash gibi olgun bir kütüphane tercih edilmelidir.
import hashlib

keys = ["if", "else", "while", "return"]
g = [1, 3, 0, 2, 1, 0, 3]

def bucket(text: str, salt: bytes) -> int:
    digest = hashlib.blake2b(text.encode(), key=salt, digest_size=8).digest()
    return int.from_bytes(digest, "big") % len(g)

def mphf(text: str) -> int:
    a = bucket(text, b"a")
    b = bucket(text, b"b")
    c = bucket(text, b"c")
    return (g[a] + g[b] + g[c]) % len(keys)

index = mphf("return")
print(index)  # İnşa edilen kümeye göre 0..3 arasında sabit bir indeks
Bu kodda bucket, anahtarı yardımcı dizideki bir kovaya yönlendirir; mphf ise üç kovadaki değerleri birleştirir. Gerçek sistemde g dizisi, keys kümesi için çakışma olmayacak şekilde oluşturulur. Ayrıca keys[index] == text kontrolü, küme dışı bir girdinin yanlışlıkla geçerli görünmesini engeller.
Ne zaman tercih edilmeli?
Dil araçlarındaki anahtar kelimeler, HTTP başlık adları, genomik referanslar, gömülü cihaz tabloları ve büyük salt-okunur indeksler MPHF için çok uygundur. Buna karşılık kullanıcıların sürekli eklediği ürün kataloğu veya oturum tablosu gibi dinamik yapılarda yeniden inşa maliyeti yüzünden klasik hash tablosu daha mantıklıdır.
Özetle MPHF, “önceden biraz daha fazla düşün, çalışma anında çok az bellek harca” yaklaşımıdır. Veri sabitse, çakışmasız indeksleme hem performans hem de bellek verimliliği açısından etkileyici bir mühendislik hamlesidir.
Yorumlar