İçindekiler
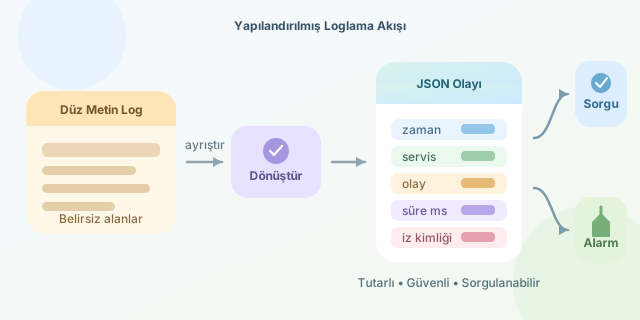
Bir uygulama küçükken Kullanıcı giriş yaptı gibi bir log satırı yeterli görünebilir. Fakat yüzlerce servisin saniyede binlerce olay ürettiği bir sistemde bu cümle, samanlıktaki iğneye dönüşür. Hangi kullanıcı, hangi servis, ne zaman ve kaç milisaniyede giriş yaptı? Yapılandırılmış loglama, bu bilgileri metnin içine saklamak yerine JSON alanları olarak yazar ve logları makinelerin kolayca sorgulayabileceği verilere dönüştürür.
``
Geleneksel loglar neden ölçeklenemez?
Basit bir metin logu genellikle insanlar düşünülerek oluşturulur:
2026-09-03 Kullanıcı 42 ödeme işlemini 850 ms içinde tamamladı
Bu satır okunabilir olsa da analiz aracı için anlamlı bölümler belirsizdir. Kullanıcı kimliği, işlem türü ve süre ancak düzenli ifadelerle ayrıştırılabilir. Mesaj formatındaki küçük bir değişiklik bile sorguları bozabilir.
Aynı olay yapılandırılmış biçimde şöyle temsil edilebilir:
{
  "timestamp": "2026-09-03T12:30:00Z",
  "level": "info",
  "service": "payment-api",
  "event": "payment_completed",
  "user_id": 42,
  "duration_ms": 850
}
Burada her bilgi, adı ve veri tipi belli olan bağımsız bir alandır. Elasticsearch, OpenSearch, Loki veya bulut tabanlı log platformları duration_ms > 500 gibi sorguları doğrudan çalıştırabilir.
Metin ve JSON karşılaştırması
| Özellik | Düz metin | Yapılandırılmış JSON |
|---|---|---|
| İnsan tarafından okunabilirlik | Yüksek | Orta-yüksek |
| Makine tarafından ayrıştırma | Zor ve kırılgan | Kolay |
| Alan bazlı sorgulama | Regex gerektirir | Doğrudan yapılır |
| Veri tiplerini koruma | Genellikle yok | Sayı, metin, boolean korunur |
| Şema tutarlılığı | Düşük | Kurallarla yükseltilebilir |
| Depolama maliyeti | Daha düşük | Alan adları nedeniyle daha yüksek |
JSON daha fazla yer kaplayabilir; ancak operasyon sırasında kazanılan hız çoğu zaman bu maliyeti dengeler. Bir olayın ortalama boyutu $B$, saniyedeki olay sayısı $R$ ve saklama süresi $T$ ise yaklaşık depolama ihtiyacı şu şekilde hesaplanabilir:
\[S = B \times R \times T\]Örneğin yapılandırma sonrasında olay boyutu iki katına çıksa bile sıkıştırma, örnekleme ve saklama politikalarıyla toplam maliyet kontrol edilebilir.
Node.js ile yapılandırılmış loglama
Üretim uygulamalarında console.log yerine Pino veya Winston gibi kütüphaneler tercih edilebilir. Aşağıdaki örnek, Pino ile bağlam bilgisi taşıyan bir olay üretir:
import pino from "pino";

const logger = pino({
  level: process.env.LOG_LEVEL || "info",
  base: { service: "order-api", environment: "production" }
});

function completeOrder(order, durationMs) {
  logger.info({
    event: "order_completed",
    order_id: order.id,
    user_id: order.userId,
    total: order.total,
    currency: "TRY",
    duration_ms: durationMs
  }, "Sipariş başarıyla tamamlandı");
}

completeOrder({ id: 918, userId: 42, total: 1299.90 }, 184);
İlk nesne sorgulanabilir alanları, son metin ise insanların okuyacağı kısa açıklamayı içerir. Böylece hem makine hem geliştirici mutlu olur; nadir görülen bir barış anlaşması!
İyi bir log şeması nasıl tasarlanır?
Alan adlarında tutarlılık temel kuraldır. Bir servis user_id, diğeri userId, üçüncüsü customer kullanırsa merkezi sorgular karmaşıklaşır. timestamp, level, service, environment, event, trace_id ve duration_ms gibi ortak alanlar belirlenmelidir.
Özellikle trace_id, dağıtık sistemlerde aynı isteğin servisler arasındaki yolculuğunu izlemeyi sağlar. Ayrıca parola, erişim anahtarı, kredi kartı veya kişisel veri loglanmamalıdır. Hassas alanlar maskeleme ya da tamamen dışlama kurallarıyla korunmalıdır.
Seviye seçimi de önemlidir: debug geliştirme ayrıntılarını, info normal iş olaylarını, warn beklenmeyen ama tolere edilen durumları, error ise müdahale gerektiren hataları belirtmelidir. Her şeyi error yapmak, yangın alarmını tost hazır olduğunda da çaldırmaya benzer.
Yapılandırılmış loglama yalnızca JSON yazmak değildir; olayları ortak, güvenli ve sorgulanabilir bir sözlükle tanımlamaktır. Doğru uygulandığında hata araştırma süresini azaltır, panoları besler, alarmları güvenilir hâle getirir ve logları okunmayı bekleyen metin yığınından operasyonel bilgiye dönüştürür.
Yorumlar