İçindekiler
Bir derleyici kaynak kodu okurken yalnızca anahtar kelimeleri tanımakla yetinmez; bu kelimelerin hangi yapıyı oluşturduğunu da çözmeye çalışır. İşte ayrıştırıcıların görevi budur. LL ve LR yöntemleri aynı token dizisine farklı yönlerden yaklaşır. Gramer yeterince açık değilse ayrıştırıcı bir yol ayrımına gelir ve meşhur “çakışma” ortaya çıkar.
``
Önce harflerin şifresini çözelim
Her iki yöntemdeki ilk L, girdinin soldan sağa okunduğunu belirtir. İkinci harf ise türetmenin niteliğini gösterir:
- LL, en soldaki nonterminali genişleterek sol türetme üretir.
- LR, sağ türetmenin tersini kurar; başka bir ifadeyle girdiden başlayıp kuralları geriye doğru uygular.
Bir grameri kabaca $G=(V,\Sigma,R,S)$ şeklinde gösterebiliriz. Burada $V$ nonterminalleri, $\Sigma$ terminalleri, $R$ üretim kurallarını ve $S$ başlangıç sembolünü temsil eder.
| Özellik | LL ayrıştırma | LR ayrıştırma |
|---|---|---|
| Temel yaklaşım | Yukarıdan aşağıya | Aşağıdan yukarıya |
| Karar biçimi | Hangi kural genişletilmeli? | Kaydırmalı mı, indirgemeli mi? |
| Sol özyineleme | Doğrudan kullanılamaz | Genellikle desteklenir |
| Gramer kapsamı | Daha sınırlı | Daha geniş |
| Uygulama | Elle yazmak kolaydır | Tablo ve araçlarla yaygındır |
| Tipik çakışma | FIRST/FIRST, FIRST/FOLLOW | Shift/reduce, reduce/reduce |
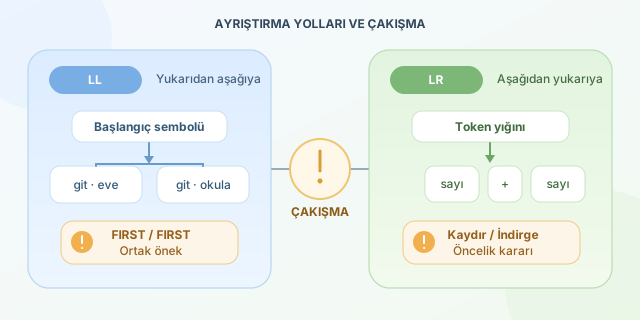
LL neden kararsız kalır?
LL ayrıştırıcı, sıradaki $k$ tokena bakarak uygulanacak üretimi seçer. LL(1) yalnızca bir tokenlık bakış kullanır. Şu grameri ele alalım:
Komut -> "git" "eve"
Komut -> "git" "okula"
Ayrıştırıcı git tokenını gördüğünde iki kural da mümkün görünür. Çünkü üretimlerin başlangıç kümeleri kesişir:
Bu bir FIRST/FIRST çakışmasıdır. Çözüm, ortak öneki dışarı almaktır; bu işleme left factoring denir:
Komut -> "git" Hedef
Hedef -> "eve" | "okula"
LL açısından bir başka bela da sol özyinelemedir:
Ifade -> Ifade "+" Sayi | Sayi
Yukarıdan aşağıya çalışan ayrıştırıcı, Ifadeyi çözmek için yeniden Ifadeye girer ve ilerlemeden sonsuz döngüye yaklaşır. Eşdeğer LL dostu biçim şöyledir:
Ifade  -> Sayi Devam
Devam  -> "+" Sayi Devam | ε
LR neden çakışır?
LR ayrıştırıcı tokenları yığına kaydırır ve bir kuralın sağ tarafını gördüğünde onu sol tarafına indirger. Sorun, sistemin aynı anda iki eylemi makul bulmasıyla başlar.
Ifade -> Ifade "+" Ifade
       | Ifade "*" Ifade
       | "sayi"
sayi + sayi * sayi dizisinde, sayi + sayi okunduktan sonra ayrıştırıcı iki seçenek görür:
- Mevcut kısmı
Ifadeolarak indirgemek. *tokenını kaydırıp çarpma yapısını büyütmek.
Bu durum shift/reduce çakışmasıdır. Matematiksel niyetimiz genellikle
\[a+b\times c = a+(b\times c)\]olduğundan, * operatörüne daha yüksek öncelik verilerek kaydırma seçilir. Öncelik bildirimleri veya katmanlı gramer kullanılabilir:
Ifade  -> Ifade "+" Terim | Terim
Terim  -> Terim "*" Faktor | Faktor
Faktor -> "sayi"
Reduce/reduce çakışması ise aynı token dizisinin iki farklı kuralla indirgenebilmesidir. Bu, çoğunlukla gramerde örtüşen kategoriler bulunduğunu gösterir.
Her çakışma belirsizlik midir?
Hayır. Belirsiz bir gramer, aynı cümle için birden fazla ayrıştırma ağacı üretir; dolayısıyla çakışma yaratabilir. Ancak belirli bir ayrıştırma algoritmasının yaşadığı çakışma, gramerin mutlaka belirsiz olduğu anlamına gelmez. Gramer yalnızca LL(1) için fazla karmaşık olabilirken LR(1) tarafından sorunsuz işlenebilir.
Pratik özet şöyledir: Basitlik, okunabilirlik ve elle yazılan recursive-descent parser için LL; daha geniş gramer desteği ve güçlü derleyici araçları için LR tercih edilir. Gramer “çakıştığında” suçlu çoğu zaman parser değil, ona karar verebilmesi için yeterince açık yol tarif etmeyen kurallardır.
Yorumlar