İçindekiler
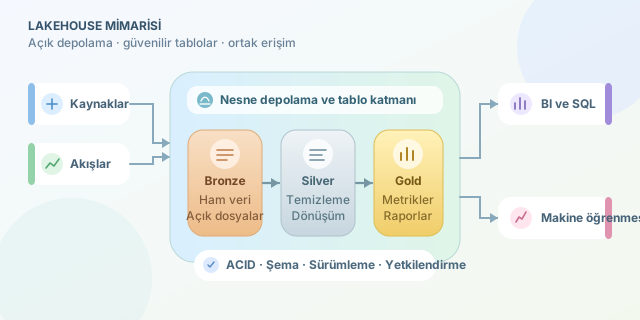
Kuruluşlar uzun süre verilerini iki ayrı dünyada yönetti: Raporlama ve karar destek için düzenli veri ambarları, ham ve büyük hacimli veriler için ise veri gölleri. Lakehouse mimarisi, bu iki yaklaşımın güçlü yanlarını tek bir platformda buluşturarak hem analitik ekiplerin hem de makine öğrenmesi ekiplerinin aynı veriye güvenle erişmesini hedefler. Kısacası gölün özgürlüğünü, ambarın düzeniyle birleştiren bir veri yerleşim planıdır. ``
Neden yeni bir mimariye ihtiyaç duyuldu?
Klasik veri ambarları şema, kalite kontrolü ve hızlı SQL sorguları açısından başarılıdır. Ancak yapılandırılmamış veriler, veri bilimi iş yükleri ve sürekli büyüyen depolama maliyetleri karşısında katı kalabilirler. Veri gölleri ise nesne depolama üzerinde dosyaları ucuza saklar; fakat yeterli yönetişim yoksa kısa sürede “veri bataklığına” dönüşebilir.
Lakehouse yaklaşımı, ham veriyi açık dosya biçimlerinde saklarken bu verinin üstüne tablo yönetimi, ACID işlemleri, şema denetimi ve sürümleme ekler. Böylece aynı depolama alanı hem BI panolarını hem Python tabanlı model eğitimini besleyebilir.
| Özellik | Veri Gölü | Veri Ambarı | Lakehouse |
|---|---|---|---|
| Veri türü | Her tür ham veri | Çoğunlukla yapılandırılmış | Her tür veri, tablo katmanıyla |
| Şema yaklaşımı | Okuma anında şema | Yazma anında şema | Her iki yaklaşım da mümkün |
| Maliyet | Düşük depolama maliyeti | Genellikle yüksek | Nesne depolama avantajı |
| Güvenilirlik | Araçlara bağlı | Yüksek | ACID ve sürümleme ile yüksek |
Temel yapı taşları
Lakehouse’un merkezinde genellikle bulut nesne depolaması bulunur. Parquet gibi sütun bazlı biçimler, yalnızca ihtiyaç duyulan kolonların okunmasına imkân verir. Delta Lake, Apache Iceberg ve Apache Hudi gibi tablo formatları ise dosya koleksiyonlarını yönetilebilir tablolara dönüştürür.
Bu katmanın önemli vaadi ACID garantileridir: atomiklik, tutarlılık, izolasyon ve dayanıklılık. Bir veri yükleme işleminin başarısız olması durumunda tablonun yarım güncellenmiş görünmemesi gerekir. Basitçe, bir işlemin tutarlı maliyeti şu şekilde düşünülebilir:
\[T_{toplam} = T_{okuma} + T_{işleme} + T_{yazma} + T_{bakım}\]Lakehouse, dosya düzenleme ve sıkıştırma gibi bakım faaliyetlerini otomatikleştirerek özellikle $T_{okuma}$ ve $T_{bakım}$ değerlerini azaltmayı amaçlar. Elbette bu kazanç; bölümleme stratejisi, dosya boyutu ve sorgu motoruna bağlıdır.
Madalyon, yani katmanlı veri akışı
Pratikte yaygın desenlerden biri Bronze-Silver-Gold katmanlarıdır. Bronze katmanı kaynaktan gelen ham veriyi mümkün olduğunca değiştirmeden tutar. Silver katmanında temizleme, tekilleştirme ve tip dönüşümleri yapılır. Gold katmanı ise satış özeti veya müşteri segmenti gibi iş birimlerinin doğrudan kullanacağı metrikleri içerir.
-- Silver tablosundan günlük satış özetini Gold katmanına yazar
CREATE OR REPLACE TABLE gold.gunluk_satis AS
SELECT
  DATE(siparis_zamani) AS tarih,
  ulke,
  SUM(tutar) AS toplam_ciro,
  COUNT(DISTINCT siparis_id) AS siparis_sayisi
FROM silver.siparisler
WHERE durum = 'tamamlandi'
GROUP BY DATE(siparis_zamani), ulke;
Bu sorgu, ham sipariş ayrıntılarını iş kararlarında kullanılabilecek toplu metriklere çevirir. Üretimde buna veri kalite testleri, erişim yetkileri ve işlem zamanını izleyen kayıtlar da eklenmelidir.
Kazanımlar ve dikkat edilmesi gerekenler
Lakehouse’un en büyük avantajı, veri kopyalarını azaltmasıdır. Aynı müşteri verisini ayrı bir veri bilimi gölüne ve raporlama ambarına taşımak yerine ortak, yönetişimli bir tablo katmanı kullanılabilir. Zaman yolculuğu (time travel) özelliği sayesinde önceki tablo sürümlerine dönmek de hatalı yüklemelerde hayat kurtarır.
Buna rağmen lakehouse sihirli değnek değildir. Küçük dosya üretimi, yanlış bölümleme, sınırsız şema değişimi ve belirsiz sahiplik performansı hızla düşürür. Başarılı bir tasarım için veri sözleşmeleri, kataloglama, satır/kolon bazlı yetkilendirme ve maliyet gözlemi birlikte planlanmalıdır.
Özetle lakehouse, tek bir ürün değil; açık depolama, güvenilir tablo formatları ve ortak veri yönetişimi etrafında kurulan bir mimari yaklaşımdır. Doğru katmanlama ile hem SQL seven analistlere hem de deney yapan veri bilimcilere aynı sahnede çalışma fırsatı verir.
Yorumlar