Büyük dil ve görüntü modelleri etkileyici sonuçlar üretir; ancak çoğu zaman pahalı, yavaş ve cihaz üzerinde çalıştırılamayacak kadar hantaldırlar. Knowledge Distillation (bilgi damıtma), büyük bir öğretmen modelin öğrendiği davranışları daha küçük bir öğrenci modele aktararak bu sorunu hedefler. Amaç öğretmeni birebir kopyalamak değil, onun karar verme ipuçlarını sıkıştırılmış bir biçimde öğrencide yaşatmaktır. ``
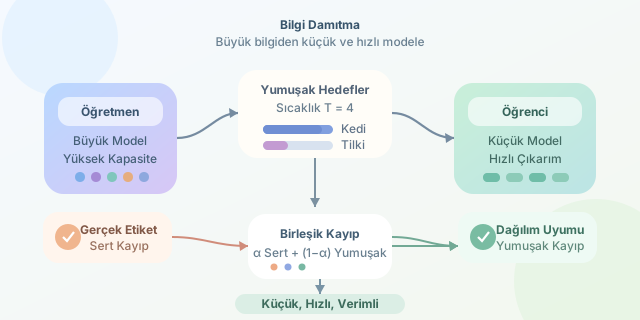
Klasik denetimli öğrenmede model, örneğin bir görselin yalnızca “kedi” olduğunu öğrenir. Oysa güçlü bir öğretmen model, tahmin dağılımında çok daha zengin bir mesaj taşır: Görselin %85 olasılıkla kedi, %10 tilki ve %3 köpek olabileceğini söyleyebilir. “Tilki” olasılığının sıfır olmaması, örneklerin görsel olarak hangi yönlerden benzeştiğini öğrenciye anlatan değerli bir sinyaldir. Distillation’ın temel fikri tam olarak bu yumuşak hedefleri kullanmaktır.
Öğretmen, öğrenci ve sıcaklık
Öğretmen modelin logits adı verilen ham çıktılarını $z_i$ ile gösterelim. Normal softmax olasılığı şöyledir:
\[p_i = \frac{e^{z_i}}{\sum_j e^{z_j}}\]Distillation sırasında bir sıcaklık parametresi $T$ eklenir:
\[p_i^{(T)} = \frac{e^{z_i/T}}{\sum_j e^{z_j/T}}\]$T > 1$ olduğunda olasılık dağılımı yumuşar; yani öğretmenin ikinci ve üçüncü tercihleri daha görünür hâle gelir. Öğrenci, hem gerçek etiketlerden hem de öğretmenin bu yumuşatılmış tahminlerinden öğrenir. Yaygın toplam kayıp fonksiyonu aşağıdaki fikre dayanır:
\[\mathcal{L} = \alpha \mathcal{L}_{CE}(y, s) + (1-\alpha)T^2\mathcal{L}_{KL}(p_t^{(T)}, p_s^{(T)})\]Burada $\mathcal{L}{CE}$ gerçek etiketler için çapraz entropi kaybını, $\mathcal{L}{KL}$ ise öğrenci ve öğretmen dağılımları arasındaki KL ayrışımını temsil eder. $\alpha$, iki öğrenme kaynağı arasındaki denge düğmesidir. $T^2$ çarpanı da sıcaklık nedeniyle ölçeklenen gradyanları dengelemeye yardımcı olur.
| Yaklaşım | Eğitim sinyali | Güçlü yanı | Sınırlaması |
|---|---|---|---|
| Normal eğitim | Sert, tek doğru etiket | Basit kurulum | Sınıflar arası benzerliği kaçırır |
| Knowledge Distillation | Etiket + öğretmen dağılımı | Küçük modelde daha iyi doğruluk | Önceden eğitilmiş öğretmen gerekir |
| Quantization | Sayısal hassasiyeti azaltma | Bellek ve hız kazancı | Tek başına bilgiyi iyileştirmez |
Basit bir PyTorch iskeleti
Aşağıdaki örnek, öğrenci kaybının nasıl hesaplandığını gösterir. Öğretmen parametreleri güncellenmez; onun görevi yalnızca rehberlik etmektir.
import torch.nn.functional as F

T = 4.0
alpha = 0.3

teacher.eval()
for x, labels in train_loader:
    with torch.no_grad():
        teacher_logits = teacher(x)

    student_logits = student(x)

    hard_loss = F.cross_entropy(student_logits, labels)
    soft_loss = F.kl_div(
        F.log_softmax(student_logits / T, dim=1),
        F.softmax(teacher_logits / T, dim=1),
        reduction="batchmean"
    ) * (T * T)

    loss = alpha * hard_loss + (1 - alpha) * soft_loss
    optimizer.zero_grad()
    loss.backward()
    optimizer.step()
Bu kodda hard_loss, öğrencinin sınavın resmi cevap anahtarından öğrenmesidir. soft_loss ise öğretmenin “bu soru biraz da şu seçeneğe benziyor” şeklindeki deneyim aktarımıdır. Pratikte $T$ için 2–8, $\alpha$ için 0.1–0.5 aralığıyla denemeler yapmak iyi bir başlangıçtır.
| Senaryo | Öğretmen | Öğrenci | Beklenen fayda |
|---|---|---|---|
| Mobil görüntü sınıflandırma | ResNet/ViT Large | MobileNet | Daha düşük gecikme |
| Çağrı merkezi NLP | Büyük Transformer | Küçük Transformer | Daha ucuz çıkarım |
| Edge cihaz | Bulut modeli | Quantize edilmiş öğrenci | Çevrimdışı kullanım |
Distillation sihirli bir küçültme düğmesi değildir: Öğrenci çok küçükse öğretmenin bilgisini taşıyacak kapasite bulamaz; öğretmen hatalıysa öğrenci de bu hataları miras alabilir. Buna rağmen doğru mimari, veri ve hiperparametrelerle kullanıldığında, üretim ortamında doğruluk-hız-maliyet üçgenini oldukça akıllıca dengeler.
Yorumlar