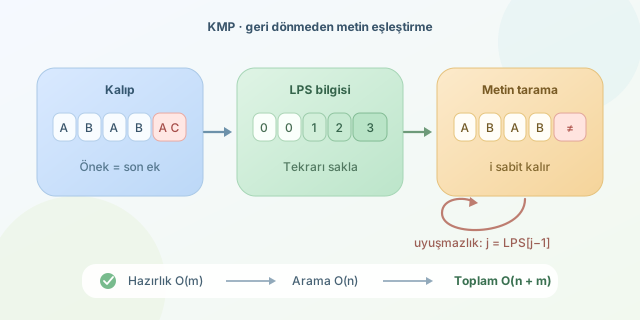
Bir metin içinde belirli bir kelimeyi, DNA dizisini ya da log kaydındaki hatayı aramak ilk bakışta basit görünür. Ancak metin milyonlarca karakter, kalıp da binlerce karakter olduğunda “uyuşmazsa başa dön” yaklaşımı pahalılaşır. Knuth-Morris-Pratt (KMP) algoritması, daha önce öğrendiği eşleşme bilgisini çöpe atmadan ilerleyerek bu problemi doğrusal zamanda çözen klasik bir tekniktir.
``
KMP’nin ana fikri şudur: Kalıbın bir kısmı eşleşti ve sonra uyuşmazlık yaşandıysa, metin işaretçisini geriye sarmaya gerek yoktur. Çünkü kalıbın kendi içindeki tekrarları bize, bir sonraki olası eşleşmenin nereden başlayacağını söyler. Örneğin ABABAC kalıbında ABABA bölümü eşleşmişken son karakter uyuşmazsa, bu beş karakterin içindeki ABA hem önek hem de son ek olarak zaten bilinir. Dolayısıyla tüm emeği sıfırlamak yerine eşleşme uzunluğunu uygun noktaya çekeriz.
Teorik temel: önek, son ek ve LPS
Bir dizginin öneki baştan başlayan, son eki ise sonda biten parçasıdır. KMP, kalıbın her konumu için en uzun uygun önek-son ek uzunluğunu hesaplar. Uygun sözcüğü önemlidir: Dizginin tamamı, kendi uygun öneği veya son eki sayılmaz.
Bu bilgi genellikle LPS (Longest Proper Prefix which is also Suffix) dizisinde tutulur. Kalıp $P$ ve uzunluğu $m$ olsun. lps[i], $P[0..i]$ alt dizisinin en uzun uygun önek-son ek uzunluğudur.
| Kalıp bölümü | En uzun uygun önek = son ek | LPS değeri |
|---|---|---|
A |
boş | 0 |
AB |
boş | 0 |
ABA |
A |
1 |
ABAB |
AB |
2 |
ABABA |
ABA |
3 |
ABABAC |
boş | 0 |
Arama sırasında metin indeksi $i$, kalıp indeksi $j$ olsun. Karakterler eşitse ikisi de artırılır. Uyuşmazlıkta $j > 0$ ise kritik hamle yapılır: $j = lps[j-1]$. Metin indeksi sabit kalır. Yalnızca $j = 0$ iken metinde ilerlenir. Böylece metindeki karakterler tekrar tekrar işlenmez.
Python ile uygulama
Aşağıdaki kod önce LPS tablosunu kurar, ardından tüm eşleşmelerin başlangıç indekslerini döndürür. Tek bir eşleşmede durmak isterseniz, ilk append işleminden sonra return kullanabilirsiniz.
def lps_olustur(kalip):
    lps = [0] * len(kalip)
    uzunluk = 0

    for i in range(1, len(kalip)):
        while uzunluk > 0 and kalip[i] != kalip[uzunluk]:
            uzunluk = lps[uzunluk - 1]

        if kalip[i] == kalip[uzunluk]:
            uzunluk += 1
            lps[i] = uzunluk

    return lps


def kmp_ara(metin, kalip):
    if not kalip:
        return list(range(len(metin) + 1))

    lps = lps_olustur(kalip)
    bulunanlar = []
    i = j = 0

    while i < len(metin):
        if metin[i] == kalip[j]:
            i += 1
            j += 1

            if j == len(kalip):
                bulunanlar.append(i - j)
                j = lps[j - 1]
        elif j > 0:
            j = lps[j - 1]
        else:
            i += 1

    return bulunanlar

print(kmp_ara("ABABABACABA", "ABABA"))  # [0, 2]
Neden gerçekten hızlı?
Naif yaklaşım, her olası başlangıç konumunda kalıbı yeniden karşılaştırabilir. En kötü durumda maliyet $O(nm)$ olur; burada $n$ metin, $m$ kalıp uzunluğudur. KMP ise LPS hazırlığını $O(m)$, aramayı $O(n)$ sürede bitirir. Toplam maliyet:
\[T(n, m) = O(m) + O(n) = O(n + m)\]| Yaklaşım | Ön hazırlık | Arama | En kötü toplam maliyet |
|---|---|---|---|
| Naif arama | $O(1)$ | $O(nm)$ | $O(nm)$ |
| KMP | $O(m)$ | $O(n)$ | $O(n+m)$ |
KMP özellikle tekrar eden karakterlerin bol olduğu metinlerde parıldar. AAAAAAAA... içinde AAAAAB aramak, naif algoritmanın sabrını sınarken KMP’nin LPS tablosu her uyuşmazlığı akıllıca yönetir. Düzenli ifadeler, editör aramaları, biyoinformatik ve ağ paketleri gibi alanlarda bu “geri dönmeden öğrenme” fikri, küçük ama güçlü bir algoritma dersidir.
Yorumlar