İçindekiler
Bir müşterinin aboneliğini iptal edip etmeyeceğini, bir e-postanın spam olup olmadığını veya bir görüntüde kedi bulunup bulunmadığını tahmin etmek sınıflandırma problemlerinin klasik örnekleridir. Karar ağaçları bu görevlerde anlaşılır kurallar üretir; rastgele ormanlar ise tek bir ağacın kararsızlığını çok sayıda ağacın ortak kararıyla dengeler. Kısacası: Tek bir uzman hata yapabilir, ama farklı uzmanlardan oluşan iyi bir kurul çoğu zaman daha isabetlidir.
``
Karar ağacı nasıl karar verir?
Karar ağacı, veriyi sorular sorarak daha homojen gruplara böler. Örneğin bir kredi başvurusunda önce gelir > 50.000 mi?, sonra gecikmiş_borç var mı? gibi koşullar uygulanabilir. Ağacın her düğümü bir özellik ve eşik seçer; yaprak düğüm ise sınıf tahminini verir.
En iyi bölünmeyi seçmek için yaygın ölçütlerden biri Gini safsızlığıdır. Bir düğümde sınıf olasılıkları $p_1, p_2, …, p_k$ ise:
\[Gini = 1 - \sum_{i=1}^{k} p_i^2\]Saf bir düğümde bütün örnekler aynı sınıftadır ve Gini değeri $0$ olur. Algoritma, bölünme sonrasında oluşan çocuk düğümlerin ağırlıklı safsızlığını mümkün olduğunca azaltmak ister. Alternatif olarak bilgi teorisinden gelen entropi de kullanılabilir: $H = -\sum_i p_i \log_2(p_i)$.
| Özellik | Karar Ağacı | Rastgele Orman |
|---|---|---|
| Model sayısı | Tek ağaç | Çok sayıda ağaç |
| Yorumlanabilirlik | Çok yüksek | Orta düzey |
| Aşırı öğrenme riski | Yüksek olabilir | Genellikle daha düşük |
| Tahmin mantığı | Tekil kurallar | Oy verme veya ortalama |
| Eğitim maliyeti | Düşük | Daha yüksek |
Tek ağacın zayıf noktası: yüksek varyans
Derin bir karar ağacı eğitim verisindeki küçük değişimlere aşırı duyarlı olabilir. Veri setine birkaç yeni kayıt eklendiğinde ilk bölünme, dolayısıyla ağacın tamamı değişebilir. Bu durum yüksek varyans olarak adlandırılır. Ağaç eğitim verisini neredeyse ezberlediğinde eğitim başarısı etkileyici görünür; ancak gerçek hayattaki yeni verilerde performans düşer.
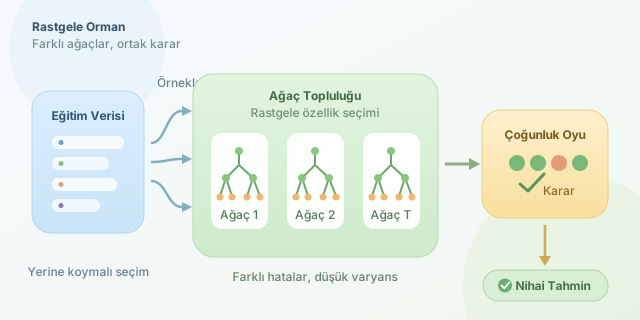
Rastgele orman, bu sorunu bagging (bootstrap aggregating) ile ele alır. Eğitim verisinden yerine koyarak birçok farklı örneklem alınır ve her örneklem üzerinde ayrı bir ağaç eğitilir. Ayrıca her düğümde tüm özellikler yerine rastgele seçilmiş bir özellik alt kümesi değerlendirilir. Böylece ağaçların birbirinin aynı olması engellenir; farklı hatalar yapan modeller ortaya çıkar.
Sınıflandırmada nihai tahmin çoğunluk oyu ile seçilir:
\[\hat{y} = \operatorname{mode}(h_1(x), h_2(x), ..., h_T(x))\]Burada $T$ ağaç sayısını, $h_t(x)$ ise $t$. ağacın tahminini ifade eder. Ağaçların hataları tam olarak aynı değilse, toplu oy verme varyansı azaltır. Bağımsız ve benzer varyanslı tahminciler için sezgisel olarak topluluğun varyansı yaklaşık $\sigma^2/T$ yönünde küçülür; pratikte ağaçlar tamamen bağımsız olmadığından bu azalma daha sınırlıdır ama yine de güçlüdür.
Python ile kısa bir uygulama
Aşağıdaki örnek, scikit-learn içindeki meme kanseri veri setinde tek ağaç ile rastgele ormanı karşılaştırır. max_depth, tek ağacın kontrolsüz büyümesini engeller; ormanda ise n_estimators kurul üyelerinin sayısıdır.
from sklearn.datasets import load_breast_cancer
from sklearn.model_selection import train_test_split
from sklearn.tree import DecisionTreeClassifier
from sklearn.ensemble import RandomForestClassifier
from sklearn.metrics import accuracy_score

X, y = load_breast_cancer(return_X_y=True)
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.25, random_state=42, stratify=y
)

tree = DecisionTreeClassifier(max_depth=5, random_state=42)
forest = RandomForestClassifier(
    n_estimators=300, max_features="sqrt", random_state=42
)

for model in (tree, forest):
    model.fit(X_train, y_train)
    print(model.__class__.__name__, accuracy_score(y_test, model.predict(X_test)))
Ormanın her zaman mucize olmadığını unutmayın: Daha fazla hesaplama, daha az şeffaflık ve sınıf dengesizliğinde yanıltıcı doğruluk oranları söz konusu olabilir. Bu nedenle yalnızca accuracy yerine precision, recall ve F1 skorlarını da inceleyin. Yine de iyi ayarlanmış bir rastgele orman, az ön işleme ihtiyacı, doğrusal olmayan ilişkileri yakalayabilmesi ve sağlam varsayılanları sayesinde sınıflandırma projeleri için güvenilir bir başlangıç noktasıdır.
Yorumlar