Bir üniversitede Veri Yapıları dersini almadan Algoritmalar dersine, Algoritmalar dersini tamamlamadan da İleri Programlama dersine kayıt olamadığınızı düşünün. Dersler arasındaki bu ön koşullar, hangi işin diğerinden önce yapılması gerektiğini gösteren bir bağımlılık ağıdır. Kahn algoritması, böyle bir ağı derinlik öncelikli arama kullanmadan, kuyruk yardımıyla geçerli bir sıraya dizer.
``
Problemi çizge olarak modellemek
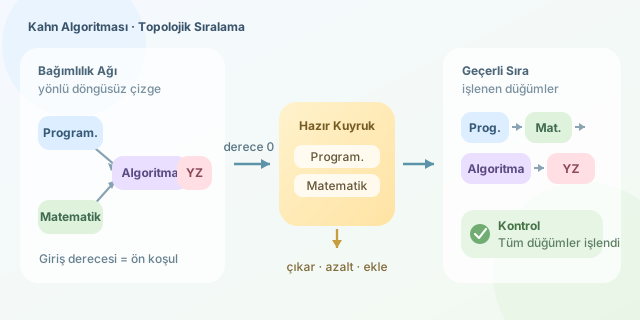
Her dersi bir düğüm, ön koşul ilişkisini ise yönlü bir kenar olarak temsil edebiliriz. Örneğin $A \rightarrow B$ kenarı, A dersinin B’den önce tamamlanması gerektiğini söyler. Topolojik sıralama yalnızca yönlü döngüsüz çizgelerde, yani DAG yapılarında mümkündür.
Bir $v$ düğümünün giriş derecesi $d^-(v)$, o düğüme gelen kenarların sayısıdır. Ders örneğinde bu değer, dersin henüz karşılanması gereken ön koşul sayısıdır. Dolayısıyla
\[d^-(v)=0\]olan bir ders hemen alınabilir. Kahn algoritmasının temel fikri tam olarak budur: Ön koşulu kalmayan düğümleri sırayla seç, çizgeden kaldır ve onların açtığı yeni seçenekleri kuyruğa ekle.
| Kavram | Ders sistemi karşılığı | Algoritmadaki görevi |
|---|---|---|
| Düğüm | Ders | Sıralanacak öğe |
| Yönlü kenar | Ön koşul ilişkisi | Zorunlu önceliği belirtir |
| Giriş derecesi | Kalan ön koşul sayısı | Düğümün hazır olup olmadığını gösterir |
| Kuyruk | Alınabilir dersler listesi | Hazır düğümleri saklar |
| Döngü | Birbirini karşılıklı bekleyen dersler | Geçerli sıralamayı engeller |
Kahn algoritması nasıl çalışır?
Önce bütün düğümlerin giriş dereceleri hesaplanır. Giriş derecesi sıfır olanlar kuyruğa yerleştirilir. Kuyruktan bir düğüm çıkarıldığında sonuç listesine eklenir. Ardından bu düğümden çıkan her kenar kaldırılmış kabul edilir ve komşuların giriş dereceleri bir azaltılır. Derecesi sıfıra düşen komşu kuyruğa katılır.
Adımlar bittiğinde sonuçtaki düğüm sayısı toplam düğüm sayısından küçükse çizgede döngü vardır. Çünkü bazı düğümler, asla sıfıra inmeyen giriş dereceleriyle birbirlerini beklemektedir. Akademik bürokrasinin algoritmik karşılığı!
from collections import deque

def kahn_topological_sort(graph):
    indegree = {node: 0 for node in graph}

    # Her dersin kaç ön koşulu olduğunu hesaplar.
    for node in graph:
        for neighbor in graph[node]:
            indegree[neighbor] += 1

    # Şu anda alınabilecek dersler kuyruğa girer.
    queue = deque(
        node for node in graph if indegree[node] == 0
    )
    order = []

    while queue:
        node = queue.popleft()
        order.append(node)

        for neighbor in graph[node]:
            indegree[neighbor] -= 1
            if indegree[neighbor] == 0:
                queue.append(neighbor)

    if len(order) != len(graph):
        raise ValueError("Bağımlılık ağında döngü var!")

    return order

courses = {
    "Programlama": ["Veri Yapıları"],
    "Veri Yapıları": ["Algoritmalar"],
    "Matematik": ["Algoritmalar"],
    "Algoritmalar": ["Yapay Zeka"],
    "Yapay Zeka": []
}

print(kahn_topological_sort(courses))
Bu kod tek bir zorunlu sıra üretmez; aynı anda hazır olan derslerin kuyruktaki dizilişine göre farklı fakat geçerli sonuçlar oluşabilir. Örneğin Programlama ve Matematik arasında doğrudan bağımlılık yoksa ikisinin yeri değişebilir.
DFS ile farkı nedir?
| Özellik | Kahn algoritması | DFS tabanlı yöntem |
|---|---|---|
| Temel yapı | Kuyruk | Çağrı yığını veya yığın |
| Yaklaşım | Giriş derecesi sıfır düğümleri seçer | Düğümlerin bitiş zamanlarını kullanır |
| Döngü tespiti | İşlenen düğüm sayısını karşılaştırır | Ziyaret durumlarını izler |
| Sezgisel anlam | Hazır işleri sıraya alır | Bağımlılıkların sonuna kadar iner |
Her düğüm ve kenar en fazla birkaç kez işlendiğinden zaman karmaşıklığı $O(V+E)$, bellek karmaşıklığı ise $O(V)$ düzeyindedir. Bu nedenle Kahn algoritması; ders planlama, paket bağımlılıkları, görev zamanlama ve derleme süreçleri gibi gerçek sistemlerde hem verimli hem de anlaşılır bir çözümdür.
Yorumlar