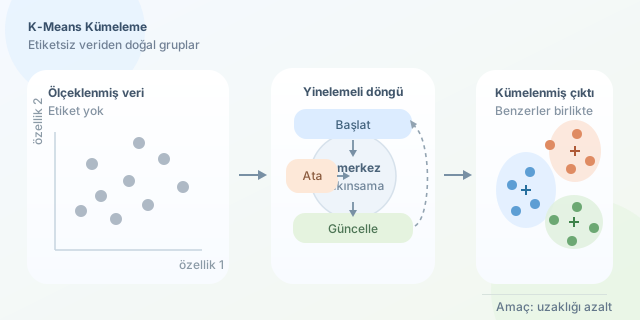
Elinizde müşteri davranışları, sensör ölçümleri ya da ürün özellikleri olsun; fakat satırlara yapıştırılmış hazır sınıf etiketleri bulunmasın. K-Means, tam bu noktada devreye giren gözetimsiz öğrenme algoritmalarından biridir. Verileri önceden bilinen sınıflara atamak yerine, benzer gözlemleri aynı kümelerde toplayarak veri içindeki doğal yapıyı görünür kılar. Bir nevi kalabalık bir partide benzer ilgi alanlarına sahip insanların kendiliğinden küçük gruplar oluşturmasını izleriz.
``
K-Means adındaki K, oluşturmak istediğimiz küme sayısını; means ise her kümenin ortalama noktasını, yani merkezini ifade eder. Algoritmanın amacı, her veri noktasını en yakın merkeze bağlamak ve bu merkezleri atanan noktaların ortalamasına göre tekrar tekrar güncellemektir. Böylece küme içindeki noktalar mümkün olduğunca yakın, farklı kümelerdeki noktalar ise mümkün olduğunca uzak kalmaya çalışır.
Matematiksel olarak K-Means, küme içi kareler toplamını en aza indirir. Amaç fonksiyonu şöyledir:
\[J = \sum_{i=1}^{K} \sum_{x \in C_i} \lVert x - \mu_i \rVert^2\]Burada $C_i$, $i$. kümeyi; $\mu_i$ o kümenin merkezini; $x$ ise bir veri noktasını temsil eder. Kare alma işlemi, merkeze uzak noktaları daha fazla cezalandırır. Uzaklık hesabında çoğunlukla Öklid uzaklığı kullanılır:
\[d(x, \mu) = \sqrt{\sum_{j=1}^{n}(x_j - \mu_j)^2}\]Algoritmanın çalışma döngüsü şaşırtıcı derecede basittir: Önce rastgele $K$ merkez seçilir, her nokta en yakın merkeze atanır, ardından merkezler yeniden hesaplanır. Atamalar değişmeyene veya belirlenen iterasyon sayısına ulaşılana kadar bu adımlar sürer.
| Adım | Ne yapılır? | Neden önemlidir? |
|---|---|---|
| Başlatma | $K$ adet başlangıç merkezi seçilir | Sonucun kalitesini doğrudan etkiler |
| Atama | Her nokta en yakın merkeze gider | Geçici kümeler oluşur |
| Güncelleme | Her kümenin yeni ortalaması alınır | Merkezler veriye yaklaşır |
| Yakınsama | Değişim durunca işlem biter | Kararlı bir çözüm elde edilir |
Aşağıdaki örnek, iki özellikten oluşan yapay veriyi üç kümeye ayırır. StandardScaler kullanımı özellikle önemlidir: Gelir binlerle, yaş ise onlarca birimle ölçülürse büyük ölçekli özellik uzaklık hesabını gereksiz biçimde domine edebilir.
import numpy as np
from sklearn.cluster import KMeans
from sklearn.preprocessing import StandardScaler

veri = np.array([
    [22, 18000], [25, 22000], [28, 24000],
    [35, 55000], [38, 60000], [41, 65000],
    [48, 90000], [52, 98000], [55, 105000]
])

# Yaş ve gelir sütunlarını aynı ölçek mantığına taşır.
olcekleyici = StandardScaler()
X = olcekleyici.fit_transform(veri)

model = KMeans(n_clusters=3, init="k-means++", n_init=10, random_state=42)
etiketler = model.fit_predict(X)

print("Küme etiketleri:", etiketler)
print("Ölçeklenmiş merkezler:\n", model.cluster_centers_)
Kodda fit_predict, modeli eğitirken her gözlemin küme numarasını da döndürür. k-means++ başlangıç merkezlerini birbirinden daha uzak seçmeye eğilimlidir; bu da rastgele kötü bir başlangıç yapma riskini azaltır. Yine de K-Means aynı veride farklı başlangıçlarla farklı yerel çözümlere ulaşabilir. Bu nedenle n_init=10, algoritmayı birden fazla kez çalıştırıp en iyi sonucu seçmeye yarar.
Peki $K$ değeri nasıl belirlenir? En yaygın yaklaşım dirsek yöntemidir. Farklı $K$ değerleri için inertia_ ölçülür; eğrideki sert düşüşün yavaşladığı nokta makul bir adaydır. Ancak dirsek her zaman net değildir. Silhouette skoru da kümelerin kendi içinde sıkı, birbirinden ayrık olup olmadığını değerlendirmek için kullanılabilir.
| Özellik | K-Means | Hiyerarşik Kümeleme |
|---|---|---|
| Küme sayısı | Başta $K$ seçilir | Sonradan kesilebilir |
| Büyük veride hız | Genellikle yüksektir | Daha maliyetli olabilir |
| Küme biçimi | Küresel ve benzer boyutlu yapıları sever | Daha esnek olabilir |
| Aykırı değer etkisi | Yüksektir | Kullanılan bağlantıya bağlıdır |
K-Means; müşteri segmentasyonu, belge gruplama, görüntü renk azaltma ve anomali ön analizi gibi alanlarda güçlü bir başlangıç aracıdır. Fakat aykırı değerler, farklı yoğunluklar ve hilal gibi kıvrımlı kümeler algoritmayı yanıltabilir. Bu yüzden veri ölçekleme, görselleştirme ve sonuçları alan bilgisiyle yorumlama, yalnızca fit_predict çağırmaktan çok daha değerlidir.
Yorumlar