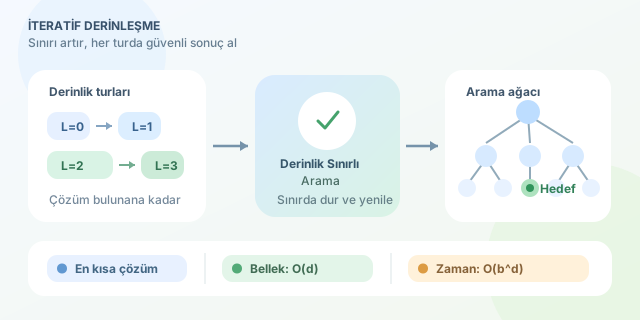
Olimpiyat ve oyun programlama yarışmalarında bazen doğru cevabı bulmak kadar, onu süre dolmadan bulmak da önemlidir. Arama uzayının derinliği önceden bilinmiyorsa ya da her hamlenin maliyeti farklıysa, tek seferde çok derine dalmak risklidir: algoritma en umut verici çözümü görmeden zaman aşımına uğrayabilir. İteratif derinleşme (Iterative Deepening), arama sınırını küçükten büyüğe artırarak bu riski yönetir. Önce derinlik 0, sonra 1, 2, 3 diye ilerler; her turda çözüm bulunursa durur.
``
Temel fikir, derinlik sınırlı aramayı (Depth-Limited Search, DLS) tekrar tekrar çalıştırmaktır. Klasik DFS bir dalın sonuna kadar inerken, DLS belirlenen $L$ sınırında durur. İteratif derinleşme ise $L = 0, 1, 2, \dots$ için DLS çağırır. Böylece BFS gibi en sığ çözümü bulma garantisi verirken, DFS gibi düşük bellek tüketir. Özellikle hamle sayısını minimize etmek istediğimiz bulmacalarda bu özellik altın değerindedir.
Arama ağacında dallanma katsayısı $b$, en sığ hedefin derinliği $d$ olsun. BFS’nin zaman maliyeti yaklaşık $O(b^d)$, bellek maliyeti de $O(b^d)$ düzeyindedir. İteratif derinleşme üst seviyeleri tekrar ziyaret ettiği için ilk bakışta pahalı görünür. Ancak düğümlerin büyük kısmı son seviyededir:
\[1 + b + b^2 + \dots + b^d\]Bu nedenle tekrarların maliyeti, $b > 1$ iken çoğu zaman küçüktür; asimptotik zaman yine $O(b^d)$ kalır. Buna karşılık bellek kullanımı DFS çağrı yığını nedeniyle yaklaşık $O(d)$ olur.
| Yaklaşım | En kısa çözüm | Zaman | Bellek | Ne zaman tercih edilir? |
|---|---|---|---|---|
| BFS | Evet | $O(b^d)$ | $O(b^d)$ | Bellek bol, kenar maliyetleri eşit |
| DFS | Hayır | Değişken | $O(d)$ | Hızlı bir herhangi çözüm yeterli |
| İteratif derinleşme | Evet | $O(b^d)$ | $O(d)$ | Derinlik bilinmiyor, bellek kısıtlı |
Aşağıdaki Python örneği, hedef sayıya +1 ve *2 işlemleriyle ulaşmak için gereken en az hamle sayısını arar. Gerçek yarışma problemlerinde durum; satranç tahtası, kelime dizisi veya oyun konfigürasyonu olabilir.
def dls(x, target, limit, path):
    if x == target:
        return path
    if limit == 0:
        return None

    for nxt, move in ((x + 1, "+1"), (x * 2, "*2")):
        # Örnek problemde gereksiz büyümeyi engelliyoruz.
        if nxt <= target * 2:
            result = dls(nxt, target, limit - 1, path + [move])
            if result is not None:
                return result
    return None


def iterative_deepening(start, target):
    for limit in range(50):
        answer = dls(start, target, limit, [])
        if answer is not None:
            return answer
    return None

print(iterative_deepening(1, 23))
Kodda limit, o turda izin verilen maksimum hamle sayısını temsil eder. İlk başarılı tur, tanım gereği en kısa çözümü üretir. Fakat pratikte dikkat edilmesi gereken bir nokta vardır: Döngülü durum uzaylarında aynı duruma tekrar dönmek aramayı şişirir. Bu yüzden yalnızca mevcut yol üzerinde bulunan durumları izleyen bir path_set kullanılabilir. Her tur için küresel bir visited kümesi kullanmak ise bazen hatalı budamaya yol açar; çünkü aynı durum, farklı kalan derinlik bütçeleriyle yeniden anlamlı hale gelebilir.
Oyun ağaçlarında iteratif derinleşme daha da güçlüdür. Satranç benzeri bir minimax aramasında derinlik 1’den başlayıp sürekli artırmak, süre kesilse bile elde geçerli bir hamle kalmasını sağlar. Ayrıca önceki turun en iyi hamlesini yeni turda ilk denemek, alfa-beta budamasını ciddi biçimde hızlandırır. Buna principal variation ordering denir.
| Durum | İteratif derinleşmenin katkısı |
|---|---|
| Kesin süre limiti | Her tamamlanan tur kullanılabilir sonuç verir |
| Hedef derinliği bilinmiyor | Gereksiz aşırı derin aramayı önler |
| Bellek sınırı | BFS’nin dev kuyruğundan kaçınır |
| Oyun motoru | En iyi hamle sıralamasıyla budamayı güçlendirir |
Özetle iteratif derinleşme, tekrar yapan ama panik yapmayan bir arama stratejisidir. Derinliği kademeli büyütür, her aşamada güvenli bir sonuç üretir ve sınırlı belleği akıllıca kullanır. Yarışmada süre düğmeye basıldığında durabilecek algoritmalara ihtiyaç duyuyorsanız, bu yöntem güçlü bir başlangıç noktasıdır.
Yorumlar