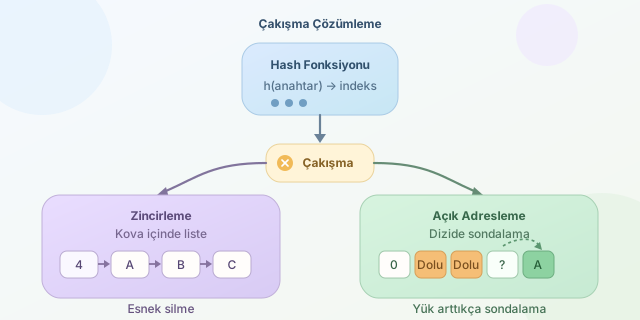
Hash tabloları, bir anahtarı hızlıca bir değere bağlamak için kullanılan en pratik veri yapılarındandır. İdeal senaryoda ekleme, arama ve silme işlemleri sabit zamanda çalışır; fakat iki farklı anahtarın aynı indekse düşmesi, yani çakışma, bu idealin küçük ama önemli düşmanıdır. Zincirleme ve açık adresleme, bu sorunu çözmek için iki temel yaklaşımdır.
``
Bir hash fonksiyonu, anahtar uzayını tablo boyutuna dönüştürür: $h(k) \in {0,1,\dots,m-1}$. Burada $m$ kova ya da hücre sayısı, $n$ ise saklanan eleman sayısıdır. Performansı anlamanın anahtarı yük faktörüdür:
\[\alpha = \frac{n}{m}\]$\alpha$ yükseldikçe çakışma olasılığı artar. Ancak iki yöntemin bu yükselişe verdiği tepki oldukça farklıdır. İyi bir hash fonksiyonu anahtarları mümkün olduğunca eşit dağıtır; zayıf bir fonksiyon ise en parlak veri yapısını bile lineer aramaya yaklaştırabilir.
Zincirleme: Her Kovaya Küçük Bir Liste
Zincirleme (separate chaining) yönteminde tablonun her hücresi bir bağlı liste, dinamik dizi veya benzeri bir koleksiyon tutar. Aynı indekse gelen anahtarlar bu koleksiyona eklenir. Böylece tablo fiziksel olarak dolsa bile yeni kayıt eklemek mümkündür; ilgili zincir sadece uzar.
class HashTable:
    def __init__(self, size=8):
        self.buckets = [[] for _ in range(size)]

    def put(self, key, value):
        bucket = self.buckets[hash(key) % len(self.buckets)]
        for i, (k, _) in enumerate(bucket):
            if k == key:
                bucket[i] = (key, value)  # Güncelleme
                return
        bucket.append((key, value))      # Çakışmada zincire ekleme
Kodda aynı kovadaki anahtarlar tek tek kontrol edilir. Ortalama zincir uzunluğu yaklaşık $\alpha$ olduğundan, iyi dağılım altında ortalama maliyet $O(1 + \alpha)$ olarak düşünülebilir. Zincirleme, silme işleminde de rahattır: düğümü ya da liste elemanını kaldırmak yeterlidir. Bunun bedeli ise her zincirin ek nesne, işaretçi ve bellek tahsisi üretmesidir.
Açık Adresleme: Tablonun İçinde Yer Aramak
Açık adresleme (open addressing) tüm kayıtları doğrudan ana dizide saklar. Bir hücre doluysa algoritma, belirli bir sondalama (probing) dizisiyle sonraki aday hücreleri dener. Doğrusal sondalama için formül şöyledir:
\[h_i(k) = (h(k) + i) \bmod m\]class LinearProbingTable:
def __init__(self, size=8):
self.slots = [None] * size
def put(self, key, value):
start = hash(key) % len(self.slots)
for i in range(len(self.slots)):
pos = (start + i) % len(self.slots)
if self.slots[pos] is None or self.slots[pos][0] == key:
self.slots[pos] = (key, value)
return
raise RuntimeError("Tablo dolu; yeniden boyutlandırılmalı")
Bu yaklaşım önbellek dostudur: veriler ardışık bellekte bulunduğundan işlemci modern donanımda daha az bellek sıçraması yapar. Buna karşılık doluluk arttıkça sondalama uzar. Özellikle doğrusal sondalama, dolu blokların büyümesine yol açan birincil kümelenme problemine açıktır. İkili sondalama ve çift hashleme bu etkiyi azaltabilir.
| Özellik | Zincirleme | Açık adresleme |
|---|---|---|
| Çakışma yeri | Kova içindeki koleksiyon | Ana dizide başka hücre |
| Yük faktörü | $\alpha > 1$ olabilir | Genellikle $\alpha < 0.7$ tutulur |
| Bellek yerelliği | Daha zayıf | Genellikle güçlü |
| Silme | Doğrudan ve kolay | deleted işaretçisi gerekebilir |
| En kötü durum | $O(n)$ | $O(n)$ |
Pratik seçimde veri yükü belirleyicidir. Sık silme yapılan, eleman sayısı dalgalanan sistemlerde zincirleme daha esnektir. Bellek yerelliğinin kritik olduğu, tabloyu zamanında büyütebildiğiniz uygulamalarda açık adresleme çoğu kez daha hızlı hissedilir. Her iki stratejide de kural değişmez: iyi hash fonksiyonu, makul yük faktörü ve doğru yeniden boyutlandırma, performansın gerçek kahramanlarıdır.
Yorumlar