İçindekiler
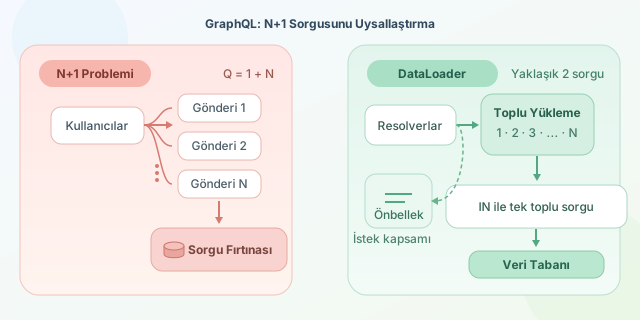
GraphQL, istemciye ihtiyacı olan veriyi seçme özgürlüğü verir; fakat bu esneklik resolver katmanında gizli bir maliyet doğurabilir. Kullanıcıları ve her kullanıcının gönderilerini listeleyen basit bir sorgu düşünün: kullanıcılar için bir sorgu, ardından her kullanıcı için ayrı gönderi sorgusu çalışır. Veri tabanı açısından masum görünen bu akış, kullanıcı sayısı arttıkça bir sorgu fırtınasına dönüşür. İşte bu klasik N+1 problemidir. ``
N+1 neden oluşur?
Bir users resolver’ı $N$ kullanıcı döndürsün. Her User.posts alanı da bağımsız olarak SELECT ... WHERE user_id = ? çalıştırsın. Toplam sorgu sayısı şöyle olur:
10 kullanıcıda 11 sorgu belki kabul edilebilir görünür; 1.000 kullanıcıda ise bağlantı havuzu, ağ gecikmesi ve veri tabanı CPU’su bu iyimserliği hızla cezalandırır. Üstelik sorgular paralel çalışsa bile kaynak tüketimi ortadan kalkmaz.
| Yaklaşım | Sorgu sayısı | Güçlü yanı | Riski |
|---|---|---|---|
| Resolver başına sorgu | $1 + N$ | Yazması çok kolay | N+1 ve yüksek gecikme |
SQL JOIN |
Genellikle 1 | Hızlı, doğrudan | Satır çoğalması ve karmaşık eşleme |
| DataLoader toplu yükleme | Yaklaşık 2 | Resolver’lar temiz kalır | Doğru yaşam döngüsü gerekir |
DataLoader’ın iki süper gücü: batching ve cache
DataLoader, aynı istek sırasında yapılan tekil yükleme çağrılarını kısa bir zaman penceresinde biriktirir. Örneğin load(1), load(2) ve load(3) çağrıları, tek bir WHERE user_id IN (1,2,3) sorgusuna dönüşür. Buna batching denir.
İkinci güç ise istek kapsamlı önbellektir. Aynı kullanıcı için iki resolver load(2) çağırırsa DataLoader sonucu yeniden kullanır. Böylece pratikte sorgu maliyeti kabaca $O(1)$ toplu sorguya yaklaşır; elbette farklı ilişki alanları için ayrı batch sorguları gerekebilir.
Node.js ve graphql-js ortamında temel bir gönderi yükleyicisi şöyle kurulabilir:
import DataLoader from 'dataloader';

const createLoaders = (db) => ({
  postsByUserId: new DataLoader(async (userIds) => {
    const rows = await db('posts')
      .whereIn('user_id', userIds)
      .orderBy('created_at', 'desc');

    const grouped = new Map(userIds.map((id) => [id, []]));
    for (const post of rows) {
      grouped.get(post.user_id).push(post);
    }

    // DataLoader, çıktının giriş anahtarlarıyla aynı sırada olmasını ister.
    return userIds.map((id) => grouped.get(id));
  })
});
Buradaki kritik ayrıntı sıradır: veri tabanı satırları userIds sırasıyla dönmek zorunda değildir. Bu nedenle sonuçları önce Map içinde grupluyor, sonra anahtarların sırasına göre dizi üretiyoruz. Bulunamayan tekil nesnelerde null, koleksiyon ilişkilerinde ise boş dizi ([]) dönmek iyi bir sözleşmedir.
Resolver tarafı şaşırtıcı derecede sade kalır:
const resolvers = {
  Query: {
    users: (_, __, { db }) => db('users').select('*')
  },
  User: {
    posts: (user, _, { loaders }) =>
      loaders.postsByUserId.load(user.id)
  }
};

const context = ({ req }) => ({
  db,
  user: req.user,
  loaders: createLoaders(db)
});
Toplu yükleme stratejisini doğru seçmek
Her ilişki için otomatik olarak DataLoader kullanmak şart değildir. Sorgu zaten tek bir nesne döndürüyor veya ORM etkili bir eager-loading planı üretiyorsa ek katman gereksiz olabilir. Ancak alan resolver’ları çok sayıda ebeveyn nesne üzerinde çalışıyorsa DataLoader ideal bir güvenlik ağıdır.
| Senaryo | Önerilen strateji | Not |
|---|---|---|
User -> posts gibi bire-çoğul ilişki |
Anahtara göre grupla | Boş dizi döndürün |
Post -> author gibi bire-bir ilişki |
ID ile toplu getir | Eksik kayıt için null |
| Çok büyük anahtar listesi | Chunking | IN parametre limitini aşmayın |
| Sık yazma işlemi | Cache temizleme | clear(id) veya prime() kullanın |
Büyük listelerde maxBatchSize belirlemek yararlıdır. Örneğin veri tabanınız 1.000 parametreden sonra zorlanıyorsa new DataLoader(batchFn, { maxBatchSize: 500 }) kullanabilirsiniz. Ayrıca filtre, dil, yetki veya sayfalama bilgisi sonucu değiştiriyorsa bunları cache anahtarına dahil edin; yalnızca userId ile cachelemek yanlış veriyi sızdırabilir.
Son kural özellikle önemlidir: DataLoader’ı global singleton yapmayın. Yükleyiciyi her GraphQL isteği için yeniden oluşturun. Aksi halde bir kullanıcının yetkili olduğu veri başka bir isteğin cache’inden sızabilir. Doğru kapsam, doğru gruplama ve ölçümlenmiş batch boyutlarıyla DataLoader; GraphQL resolver’larını hem zarif hem de ölçeklenebilir hale getirir.
Yorumlar