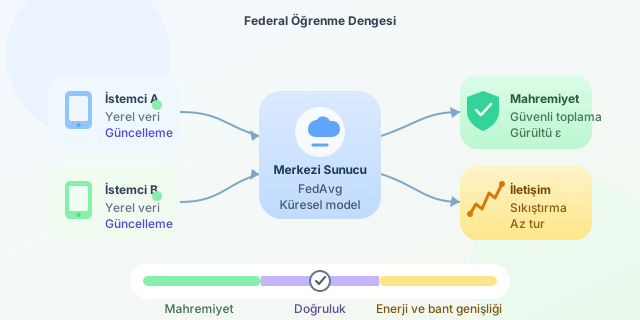
Bir makine öğrenmesi modelini eğitmek için herkesin verisini tek bir sunucuya taşımak, pratik görünse de mahremiyet açısından risklidir. Sağlık kayıtları, klavye davranışları veya finansal işlemler gibi veriler cihazdan ayrılmadan öğrenme yapılabilirse tablo değişir. Federal öğrenme (Federated Learning, FL), modeli verinin bulunduğu yere götürerek bu fikri hayata geçirir. Ancak bu yaklaşım sihirli bir gizlilik pelerini değildir: Daha güçlü mahremiyet önlemleri çoğu zaman daha fazla iletişim, hesaplama veya model doğruluğu kaybı anlamına gelir.
``
Federal öğrenmenin temel döngüsü oldukça sezgiseldir. Merkezi sunucu bir başlangıç modeli $w_t$ gönderir; seçilen istemciler kendi yerel verileri üzerinde birkaç eğitim adımı uygular ve yalnızca model güncellemesini geri iletir. Sunucu bu güncellemeleri, yaygın olarak FedAvg algoritmasıyla birleştirir:
\[w_{t+1} = \sum_{k=1}^{K} \frac{n_k}{n} w_{t+1}^{(k)}\]Burada $n_k$, $k$ istemcisindeki örnek sayısını; $n$ ise toplam örnek sayısını temsil eder. Ham veri sunucuya gitmez, fakat güncellemeler yine de veri hakkında ipucu taşıyabilir. Örneğin bir saldırgan, gradyanlardan eğitimdeki hassas bir örneğin varlığını tahmin etmeye çalışabilir. Yani “veri taşınmadı” demek, otomatik olarak “tam gizlilik sağlandı” demek değildir.
| Yaklaşım | Mahremiyet | İletişim maliyeti | Tipik risk |
|---|---|---|---|
| Merkezi eğitim | Düşük | Veri bir kez taşınır | Ham veri ihlali |
| Temel federal öğrenme | Orta | Çok sayıda model turu | Gradyan sızıntısı |
| Güvenli toplama | Yüksek | Ek şifreleme yükü | İstemci kopmaları |
| Diferansiyel gizlilik | Çok yüksek | Gürültü ve ek tur ihtiyacı | Doğruluk düşüşü |
Mahremiyeti güçlendirmek için iki popüler araç vardır. Güvenli toplama (secure aggregation), sunucunun tek tek istemci güncellemelerini değil, yalnızca toplamlarını görmesini sağlar. Böylece “Ayşe’nin telefonu ne öğrendi?” sorusu yerine “topluluk genel olarak ne öğrendi?” sorusu kalır. Diferansiyel gizlilik ise güncellemelere kontrollü gürültü ekler. Kabaca, bir kişinin verisi eklense veya çıkarılsa bile model çıktısının belirgin şekilde değişmemesi hedeflenir. Gizlilik bütçesi genellikle $\epsilon$ ile ifade edilir: Daha küçük $\epsilon$, daha güçlü mahremiyet; fakat çoğunlukla daha fazla gürültü demektir.
İletişim tarafında asıl maliyet, modelin milyonlarca parametresinin tekrar tekrar cihazlar ile sunucu arasında dolaşmasıdır. Her turdaki iletişim yaklaşık olarak şöyle düşünülebilir:
\[C \approx R \times M \times S\]$R$ eğitim turu sayısı, $M$ katılan istemci sayısı ve $S$ güncelleme boyutudur. Büyük bir dil modeli ile binlerce mobil cihazı buluşturursanız, Wi-Fi faturası olmasa bile bant genişliği ve pil tüketimi hemen hikâyenin kötü karakterine dönüşür.
Bu maliyeti azaltmak için güncellemeler sıkıştırılabilir, küçük değerler budanabilir veya yalnızca en önemli gradyanlar gönderilebilir. Ayrıca istemcilerin yerelde daha fazla epoch eğitmesi, tur sayısını azaltabilir. Fakat yerel eğitim fazla uzarsa cihazlardaki veri dağılımları farklı olduğu için modelin küresel yönü şaşabilir. Buna non-IID veri problemi denir: Bir telefonda çoğunlukla kedi fotoğrafı, diğerinde yalnızca köpek fotoğrafı varsa ortalama almak beklenenden zorlaşır.
Aşağıdaki sadeleştirilmiş kod, istemci tarafındaki yerel güncelleme fikrini gösterir:
# global_model sunucudan alınır; data cihazdan dışarı çıkmaz.
def local_train(global_model, data, epochs=2):
    model = global_model.copy()
    for _ in range(epochs):
        for x, y in data:
            loss = model.train_step(x, y)
    return model.weights - global_model.weights  # yalnızca güncelleme gönderilir
Üretim ortamında bu fark vektörü kırpılır, gerekirse gürültülenir ve güvenli toplama protokolüyle maskelenir. En iyi tasarım tek bir “en gizli” ayar değildir. Sağlık uygulaması küçük $\epsilon$, güvenli toplama ve daha seyrek turları tercih edebilir; klavye öneri sistemi ise doğruluğu korumak için daha dikkatli sıkıştırma kullanabilir. Federal öğrenmenin gerçek başarısı, mahremiyet, doğruluk, enerji ve iletişim bütçesini ürünün risk profiline göre birlikte optimize etmektir.
Yorumlar