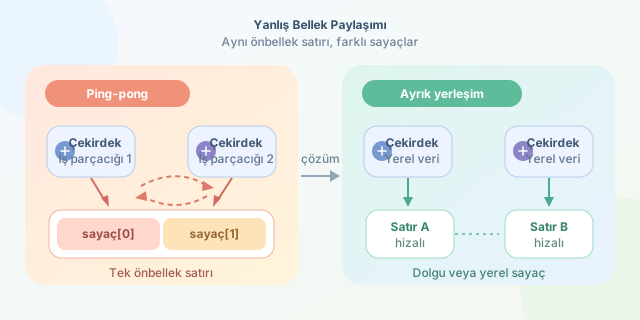
Paralel programlarda çekirdek sayısını artırmak her zaman beklenen hızlanmayı getirmez. Bazen iş parçacıkları farklı değişkenlerle çalıştığını düşündüğümüz hâlde uygulama yavaşlar, CPU kullanımı yükselir ve profil sonuçları gizemli görünür. Bu durumun sık rastlanan sorumlularından biri false sharing ya da Türkçesiyle yanlış bellek paylaşımıdır. Sorun, verinin mantıksal olarak değil, işlemcinin önbellek satırları düzeyinde paylaşılmasından doğar. `` Modern işlemciler ana belleğe doğrudan ve sürekli erişmek yerine verileri L1, L2 ve L3 önbelleklerinde tutar. Önbellekler veriyi tek tek baytlar hâlinde değil, genellikle 64 baytlık cache line blokları hâlinde taşır. Bir çekirdek bu bloktaki tek bir değeri değiştirdiğinde, çok çekirdekli tutarlılık protokolü diğer çekirdeklerde bulunan aynı satırın kopyalarını geçersiz kılabilir.
Temel maliyeti şu şekilde düşünebiliriz:
\[T_{toplam} = T_{hesaplama} + T_{bellek} + T_{senkronizasyon} + T_{cache\_line\_pingpong}\]False sharing durumunda son terim büyür. Kodda açık bir kilit, atomik sayaç paylaşımı veya veri yarışı olmayabilir; ancak iki bağımsız değişken fiziksel olarak aynı cache line içindeyse satır çekirdekler arasında sürekli gidip gelir. Buna sıklıkla cache line ping-pong denir.
| Durum | Mantıksal paylaşım | Fiziksel cache line paylaşımı | Beklenen etki |
|---|---|---|---|
| Gerçek paylaşım | Evet | Evet | Senkronizasyon gerekir, maliyet doğaldır |
| False sharing | Hayır | Evet | Gereksiz invalidation, ciddi yavaşlama |
| Tam ayrışma | Hayır | Hayır | Çekirdekler daha bağımsız çalışır |
Örneğin iki iş parçacığı bir dizinin komşu elemanlarını güncellesin. counters[0] ve counters[1] farklı değişkenlerdir; fakat bellekte yan yana olduklarından aynı 64 baytlık satıra sığabilirler. Her artırma işlemi diğer çekirdeğin önbellek satırını geçersiz bırakır.
#include <atomic>
#include <thread>

struct Counters {
    std::atomic<long> left{0};
    std::atomic<long> right{0};
};

int main() {
    Counters counters;

    std::thread t1([&] {
        for (long i = 0; i < 100'000'000; ++i) {
            counters.left.fetch_add(1, std::memory_order_relaxed);
        }
    });

    std::thread t2([&] {
        for (long i = 0; i < 100'000'000; ++i) {
            counters.right.fetch_add(1, std::memory_order_relaxed);
        }
    });

    t1.join();
    t2.join();
}
Buradaki memory_order_relaxed, gereksiz sıralama garantilerini azaltabilir; fakat false sharing’i çözmez. Problem atomik işlemin kendisinden çok, iki sayacın aynı önbellek satırında olabilmesidir. Çözüm olarak alanlar arasına dolgu eklenebilir veya C++17 ile std::hardware_destructive_interference_size kullanılabilir.
#include <atomic>
#include <new>

struct alignas(std::hardware_destructive_interference_size) PaddedCounter {
    std::atomic<long> value{0};
};

struct Counters {
    PaddedCounter left;
    PaddedCounter right;
};
alignas her sayacın ayrı ve yıkıcı etkileşim olasılığı düşük bir hizalamaya yerleştirilmesini hedefler. Ancak bu yaklaşım bellek tüketimini artırır; her küçük veri için körlemesine padding uygulamak iyi bir fikir değildir.
False sharing özellikle yüksek frekanslı sayaçlarda, telemetry metriklerinde, iş kuyruklarının durum alanlarında ve paralel döngülerde görülür. Paralel bir diziyi parçalarken her iş parçacığına ardışık ama küçük komşu aralıklar vermek de risk oluşturabilir. Buna karşılık büyük bloklar hâlinde bölme, iş parçacığına özel yerel sayaç kullanma ve sonunda azaltma (reduction) yapma genellikle daha sağlıklıdır.
| Teknik | Avantaj | Dikkat edilmesi gereken |
|---|---|---|
| Padding / hizalama | Ping-pong’u azaltır | Bellek ayak izi büyür |
| Thread-local veri | Paylaşımı en aza indirir | Sonuçları birleştirmek gerekir |
| Blok tabanlı iş bölümü | Önbellek yerelliğini iyileştirir | Yük dengesi bozulabilir |
| Profilleme | Gerçek darboğazı gösterir | Mikro benchmark yanıltıcı olabilir |
Sonuç olarak false sharing, doğruluğu değil performansı bozan sinsi bir problemdir. Kodunuz yarışsız ve kilitsiz olsa bile yavaş olabilir. Şüpheli durumlarda çekirdek ölçeklenmesini ölçün: iki çekirdek, tek çekirdekten anlamlı biçimde hızlı değilse bellek yerleşimini ve cache line davranışını inceleme zamanı gelmiş olabilir.
Yorumlar