Dağıtık bir sistemde sorun çözmek, farklı sunuculara bağlanıp milyonlarca satır log arasında iğne aramaya benzeyebilir. ELK Stack; uygulama, konteyner, sunucu ve servis loglarını tek merkezde toplayarak bu karmaşayı aranabilir, filtrelenebilir ve görselleştirilebilir bir veri akışına dönüştürür. Böylece “Kullanıcı neden hata aldı?” sorusu, uzun bir terminal maratonu yerine birkaç saniyelik bir sorguya dönüşür. ``
ELK adı üç temel bileşenden gelir: Elasticsearch, Logstash ve Kibana. Güncel mimarilerde hafif log taşıyıcıları olan Beats de sıkça kullanılır; örneğin Filebeat dosya loglarını okuyup Logstash’e veya doğrudan Elasticsearch’e iletebilir. Temel fikir oldukça nettir: logu üret, taşı, dönüştür, indeksle ve keşfet.
| Bileşen | Temel görevi | Örnek kullanım |
|---|---|---|
| Elasticsearch | Veriyi indeksler ve dağıtık arama sunar | status:500 hatalarını aramak |
| Logstash | Logları toplar, ayrıştırır, zenginleştirir | Apache satırını alanlara bölmek |
| Kibana | Arama, dashboard ve alarm arayüzü sağlar | Hata oranı grafiği oluşturmak |
| Filebeat | Hafif log ajanı olarak veri taşır | Docker konteyner loglarını göndermek |
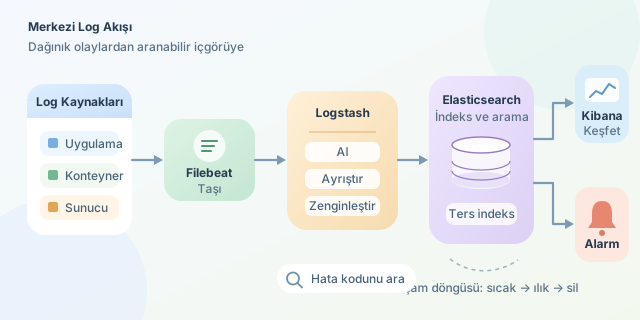
Elasticsearch’in gücü, klasik ilişkisel veritabanlarındaki satır odaklı aramadan farklı bir indeks yaklaşımından gelir. Metin alanları analiz edilir; kelimeler ters indeks yapısında tutulur. Basitçe, bir kelimenin hangi dokümanlarda geçtiği önceden hazırlanır. Arama maliyetini kabaca $O(N)$ yerine, indeks yapısına bağlı olarak $O(\log N)$ seviyesine yaklaştırmak mümkündür. Bu nedenle milyonlarca olay arasından belirli bir hata kodunu bulmak son derece hızlıdır.
Logstash ise bir veri hattı olarak düşünülmelidir. Input veriyi alır, filter veriyi dönüştürür, output ise hedefe yollar. Ham logları yalnızca saklamak yeterli değildir; zaman damgası, servis adı, ortam bilgisi ve hata seviyesi gibi alanlara ayırmak sorguları çok daha güvenilir yapar. Aşağıdaki yapı, Nginx erişim loglarını ayrıştırıp Elasticsearch’e gönderir:
input {
  beats { port => 5044 }
}

filter {
  grok {
    match => { "message" => "%{COMBINEDAPACHELOG}" }
  }
  date {
    match => [ "timestamp", "dd/MMM/yyyy:HH:mm:ss Z" ]
  }
  mutate {
    add_field => { "service" => "web-gateway" }
  }
}

output {
  elasticsearch {
    hosts => ["http://elasticsearch:9200"]
    index => "nginx-logs-%{+YYYY.MM.dd}"
  }
}
Bu konfigürasyondaki grok filtresi, tek parça metni IP adresi, HTTP metodu, istek yolu, durum kodu ve kullanıcı ajanı gibi anlamlı alanlara dönüştürür. date filtresi de olay zamanını doğru zaman alanına taşır. Bu ayrım önemlidir: message içinde arama yapmak esnek ama maliyetliyken, response:500 gibi alan bazlı sorgular daha tutarlı ve hızlıdır.
Kibana, indekslenen verinin gözle görünür hale geldiği yerdir. Discover ekranında KQL ile service:"web-gateway" and response:>=500 sorgusu çalıştırılabilir. Lens ile zaman içinde hata sayısı, en çok hata üreten endpoint’ler veya ülkelere göre istek dağılımı gösterilebilir. Hata oranı için yararlı bir metrik şöyledir:
| Yaklaşım | Avantaj | Sınırlama |
|---|---|---|
| Sunucuya SSH ile log okumak | Başlangıçta hızlıdır | Merkezi arama ve geçmiş analizi zayıftır |
| ELK ile merkezi yönetim | Arama, dashboard, alarm ve korelasyon sağlar | Kaynak ve indeks yönetimi gerektirir |
| Sadece ham log saklamak | Ucuz ve basittir | Yapısal sorgu ve görselleştirme zordur |
Üretimde indeks yaşam döngüsü yönetimi (ILM) kullanmak akıllıcadır. Yeni indeksler “hot” katmanda hızlı disklerde tutulabilir, eski veriler “warm” katmana taşınabilir ve belirli bir süreden sonra silinebilir. Ayrıca hassas verileri Logstash filtreleriyle maskelemek, disk kullanımını izlemek ve dashboard’lara yetki vermek gerekir. Doğru tasarlanmış bir ELK kurulumu yalnızca log deposu değil, sisteminizin gerçek zamanlı gözlem merkezi olur.
Yorumlar