İçindekiler
Büyük ölçekli bir sistemde loglar, uygulamanın kara kutu uçuş kayıtları gibidir: hata anını, kullanıcı davranışını ve altyapıdaki küçük titreşimleri saklarlar. Ancak binlerce sunucu saniyede milyonlarca satır ürettiğinde, metin dosyalarını tek tek incelemek hem yavaş hem de yanıltıcıdır. Elastic Stack; logları toplamak, dönüştürmek, indekslemek ve görselleştirmek için merkezi, ölçeklenebilir bir yaklaşım sunar. ``
Neden merkezi log analizi?
Dağıtık mimarilerde bir kullanıcının tek isteği API Gateway, kimlik doğrulama servisi, ödeme servisi ve veritabanı katmanından geçebilir. Bir hata oluştuğunda ilgili kayıtlar farklı makinelerde ve farklı zaman damgalarıyla bulunur. Merkezi analiz, bu parçaları aynı sorgu alanında buluşturur.
Temel amaç, ham olayları aranabilir belgelere dönüştürmektir. Her log kaydını bir belge, alanlarını ise sorgulanabilir öznitelikler olarak düşünebiliriz. Örneğin hata oranı basitçe şöyle hesaplanabilir:
\[\text{Hata Oranı} = \frac{\text{5xx yanıt sayısı}}{\text{toplam istek sayısı}} \times 100\]Bu oran zaman içinde yükseliyorsa, dashboard henüz kullanıcı şikâyet etmeden alarm üretebilir.
| Yaklaşım | Güçlü yanı | Sınırlaması |
|---|---|---|
Sunucuda grep kullanmak |
Hızlı, araç gerektirmez | Makineler arası korelasyon zordur |
| Dosyaları merkezi diske taşımak | Basit arşivleme | Gerçek zamanlı arama ve şema zayıftır |
| Elastic Stack | Arama, filtreleme, görselleştirme ve alarm | İndeks ve kaynak yönetimi ister |
Stack’in görev paylaşımı
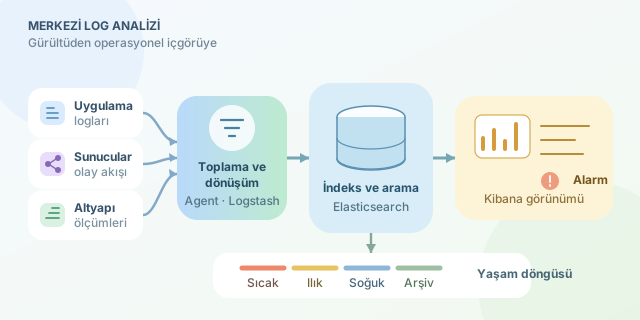
Elastic Stack çoğunlukla dört parçayla anlatılır. Beats veya Elastic Agent, logları kaynağından güvenli şekilde toplar. Logstash; ayrıştırma, zenginleştirme ve yönlendirme hattıdır. Elasticsearch belgeleri indeksler ve dağıtık arama sağlar. Kibana ise sorguların, dashboard’ların ve uyarıların arayüzüdür.
Logstash özellikle yapılandırılmamış metni anlamlı alanlara ayırmak için faydalıdır. Aşağıdaki boru hattı, Nginx benzeri bir erişim kaydını ayrıştırır; istemci IP’sini, HTTP metodunu ve durum kodunu Elasticsearch’e gönderir.
input {
  beats { port => 5044 }
}

filter {
  grok {
    match => { "message" => "%{COMBINEDAPACHELOG}" }
  }
  date {
    match => [ "timestamp", "dd/MMM/yyyy:HH:mm:ss Z" ]
  }
}

output {
  elasticsearch {
    hosts => ["https://es01:9200"]
    index => "nginx-access-%{+YYYY.MM.dd}"
  }
}
Bu örnekte grok, serbest metni alanlara böler; date ise olay zamanını doğru biçimde yorumlar. Böylece Kibana’da response: 500 gibi alan tabanlı sorgular kullanılabilir. Üretimde TLS, kimlik doğrulama ve başarısız gönderimler için kuyruklandırma da mutlaka planlanmalıdır.
İndeksleme mantığı ve ölçek
Elasticsearch, veriyi shard adı verilen parçalara böler. Her shard bağımsız aranabildiği için arama yükü düğümlere dağıtılır. Fakat “daha çok shard her zaman daha hızlıdır” düşüncesi yanlıştır; çok küçük shard’lar bellek ve koordinasyon maliyetini artırır. İndeks yaşam döngüsü yönetimi (ILM) ile sıcak veriyi hızlı disklerde tutup eski indeksleri daha ekonomik katmanlara taşıyabilirsiniz.
| Veri dönemi | Önerilen işlem | Amaç |
|---|---|---|
| Son 7 gün | Hot katmanda indeksleme | Hızlı sorgu ve dashboard |
| 8-30 gün | Warm katmana taşıma | Daha düşük maliyet |
| 30+ gün | Silme veya snapshot | Saklama politikasına uyum |
Anlamlı dashboard ve alarm tasarımı
İyi bir dashboard, sadece renkli grafik değildir; operatörün sorusuna cevap verir. İstek hacmi, p95 gecikme, hata oranı, en çok hata üreten endpoint ve servis bazlı log yoğunluğu başlangıç için güçlü panellerdir. Özellikle trace.id, service.name, environment ve log.level gibi alanları standartlaştırmak, servisler arası korelasyonu dramatik biçimde kolaylaştırır.
Son olarak, her logu indekslemek zorunda değilsiniz. Debug kayıtlarını örneklemek, hassas verileri maskelemek ve gereksiz alanları göndermemek maliyeti azaltır. Elastic Stack’in gerçek gücü, devasa günlük yığınını saklamasında değil; doğru şema, doğru saklama politikası ve doğru sorularla onu operasyonel kararlara dönüştürmesindedir.
Yorumlar