İçindekiler
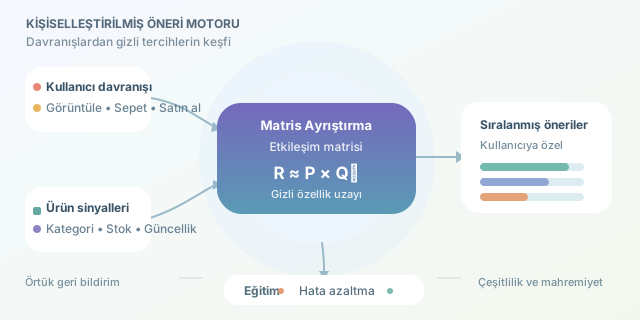
Bir e-ticaret mağazasına girdiğinizde karşınıza çıkan “Bunları da beğenebilirsiniz” bölümü tesadüfen hazırlanmaz. İşbirlikçi filtreleme, kullanıcıların görüntüleme, sepete ekleme, satın alma veya puanlama gibi geçmiş etkileşimlerinden ortak davranış kalıpları çıkarır. Matris ayrıştırma ise milyonlarca etkileşimin arkasındaki gizli tercihleri keşfederek her kullanıcıya özel ürün önerileri üretir.
``
İşbirlikçi filtrelemenin temel fikri
İşbirlikçi filtreleme, ürünlerin açıklamalarından çok kullanıcı davranışlarına güvenir. Mantığı basittir: Geçmişte benzer ürünlerle etkileşime giren kullanıcıların gelecekte de benzer tercihler yapması beklenir.
Yaklaşımlar iki ana gruba ayrılır:
| Yaklaşım | Temel soru | Güçlü yönü | Zayıf yönü |
|---|---|---|---|
| Kullanıcı tabanlı | Bana benzeyen kişiler ne aldı? | Açıklanması kolaydır | Büyük kullanıcı kümelerinde maliyetlidir |
| Ürün tabanlı | Bu ürünü alanlar başka ne aldı? | Ürün ilişkileri daha kararlıdır | Yeni ürünlerde veri azdır |
| Model tabanlı | Etkileşimlerin gizli yapısı nedir? | Ölçeklenebilir ve isabetlidir | Eğitim ve ayar gerektirir |
Klasik yöntemlerde kullanıcılar veya ürünler arasındaki kosinüs benzerliği hesaplanabilir. Fakat milyonlarca kullanıcı ve ürün olduğunda bütün benzerlikleri saklamak pahalılaşır. Matris ayrıştırma bu noktada sahneye çıkar.
Etkileşim matrisini parçalamak
Kullanıcı-ürün etkileşimlerini $R$ matrisiyle gösterelim. Satırlar kullanıcıları, sütunlar ürünleri temsil eder. $R_{ui}$ değeri kullanıcının ürüne verdiği puan veya dönüştürülmüş etkileşim ağırlığıdır.
Matris ayrıştırma, bu büyük ve seyrek matrisi iki küçük matrise yaklaşık olarak böler:
\[R \approx P Q^T\]Burada $P$, kullanıcıların gizli özelliklerini; $Q$ ise ürünlerin aynı gizli uzaydaki özelliklerini taşır. Örneğin sistem, isim vermeden “fiyat hassasiyeti”, “spor ürünlerine ilgi” veya “premium marka eğilimi” gibi boyutlar öğrenebilir. Kullanıcı $u$ için ürün $i$ tahmini şöyledir:
\[\hat{r}_{ui}=p_u^Tq_i\]Gerçek ve tahmin edilen değerler arasındaki farkı küçültmek için düzenlileştirilmiş hata fonksiyonu kullanılır:
\[\min_{P,Q}\sum_{(u,i)\in K}(r_{ui}-p_u^Tq_i)^2+\lambda(\lVert p_u\rVert^2+\lVert q_i\rVert^2)\]$K$, yalnızca gözlemlenen etkileşimleri içerir. $\lambda$ parametresi modelin ezberlemesini engeller; yani modelin her tıklamayı hayat memat meselesi yapmasını önler.
Python ile sade bir eğitim döngüsü
Aşağıdaki kod, gözlemlenmiş puanlar üzerinde stokastik gradyan inişi uygular:
import numpy as np

ratings = [(0, 0, 5), (0, 2, 3), (1, 1, 4), (2, 0, 4)]
user_count, item_count, factors = 3, 3, 8
P = np.random.normal(0, 0.1, (user_count, factors))
Q = np.random.normal(0, 0.1, (item_count, factors))
learning_rate, regularization = 0.01, 0.02

for epoch in range(100):
    np.random.shuffle(ratings)
    for user, item, score in ratings:
        error = score - np.dot(P[user], Q[item])
        old_user = P[user].copy()
        P[user] += learning_rate * (error * Q[item] - regularization * P[user])
        Q[item] += learning_rate * (error * old_user - regularization * Q[item])

predictions = P[0] @ Q.T
recommended_items = np.argsort(predictions)[::-1]
print(recommended_items)
Kod, her etkileşim için tahmin hatasını hesaplar ve kullanıcı ile ürün vektörlerini günceller. Gerçek sistemlerde kullanıcı ve ürün yanlılıkları, zaman etkisi, mini-batch eğitim ve GPU desteği de eklenir.
Tıklama ile satın alma aynı şey değildir
E-ticarette çoğu kullanıcı puan bırakmaz. Bu nedenle görüntüleme ve satın alma gibi örtük geri bildirimler ağırlıklandırılır:
| Etkileşim | Örnek ağırlık |
|---|---|
| Ürün görüntüleme | 1 |
| Favoriye ekleme | 3 |
| Sepete ekleme | 5 |
| Satın alma | 10 |
Bu değerler evrensel değildir; A/B testleriyle belirlenmelidir. Ayrıca eğitim verisi zamana göre bölünmeli ve model Precision@K, Recall@K, NDCG gibi metriklerle değerlendirilmelidir.
Soğuk başlangıç ve üretim gerçekleri
Yeni kullanıcı veya yeni ürün henüz etkileşim taşımadığı için matris ayrıştırma tek başına yetersiz kalır. Popüler ürünler, kategori tercihleri ve içerik tabanlı özelliklerle hibrit bir sistem kurulabilir. Sonuçta başarılı öneri sistemi yalnızca doğru tahmin yapan değil; çeşitlilik, güncellik, stok durumu ve kullanıcı mahremiyetini birlikte gözeten sistemdir. Doğru tasarlandığında matris ayrıştırma, dijital mağazayı herkese aynı vitrini gösteren bir katalogdan kişisel alışveriş asistanına dönüştürür.
Yorumlar