İçindekiler
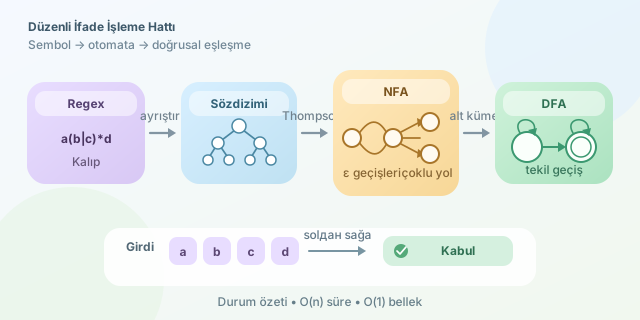
Bir düzenli ifadeye baktığımızda yalnızca parantezler, yıldızlar ve gizemli ters eğik çizgiler görürüz. İşlemci ise bu sembollerin şiirselliğiyle ilgilenmez; ona karşılaştırmalar, geçişler ve kesin kurallar gerekir. Otomat kuramı, a(b|c)*d gibi bir metin kalıbını sonlu sayıda duruma sahip bir makineye dönüştürerek bu iki dünya arasında köprü kurar.
``
Düzenli dil nedir?
Düzenli ifadeler, düzenli dilleri tanımlar. Bir alfabe $\Sigma$ üzerindeki dil, bu alfabeden üretilebilen dizelerin bir alt kümesidir. Örneğin $\Sigma={a,b}$ için sonu b ile biten bütün dizeler düzenli bir dil oluşturur.
Temel regex işlemleri matematiksel olarak şöyledir:
| Regex işlemi | Dil işlemi | Örnek |
|---|---|---|
a|b |
Birleşim | a veya b |
ab |
Birleştirme | Önce a, sonra b |
a* |
Kleene yıldızı | Sıfır veya daha fazla a |
a+ |
En az bir tekrar | a, aa, aaa… |
Kleene yıldızı için $L^*=\bigcup_{i=0}^{\infty}L^i$ yazılır. Sonsuz olasılık korkutucu görünse de makinenin sonsuz belleğe ihtiyacı yoktur; tekrar, aynı duruma geri dönen bir geçişle temsil edilir.
Regex nasıl otomata dönüşür?
Klasik süreç üç aşamalıdır:
- Regex ayrıştırılır ve bir sözdizimi ağacı oluşturulur.
- Thompson yapımıyla bir NFA üretilir.
- Alt küme yöntemiyle NFA, gerekirse DFA biçimine dönüştürülür.
NFA, aynı karakter için birden fazla geçişe ve hiçbir karakter tüketmeyen $\varepsilon$ geçişlerine izin verir. Örneğin a|b ifadesinde başlangıç durumu, iki farklı kola $\varepsilon$ ile ayrılabilir. DFA ise her durum ve karakter çifti için tam olarak tek hedef seçer.
| Özellik | NFA | DFA |
|---|---|---|
| Aynı girdide geçiş | Birden fazla olabilir | Yalnızca bir tane |
| $\varepsilon$ geçişi | Var olabilir | Yoktur |
| Yürütme yaklaşımı | Durum kümesi izlenir | Tek durum izlenir |
| Bellek ihtiyacı | Genellikle daha küçük | Dönüşümde büyüyebilir |
Alt küme yapımında her DFA durumu, NFA durumlarının bir kümesidir. NFA’da $n$ durum varsa teorik üst sınır $2^n$ DFA durumudur. Bu büyüme her zaman gerçekleşmez; erişilemeyen durumlar atılır ve DFA minimizasyonuyla eşdeğer durumlar birleştirilebilir.
İşlemci eşleşmeyi nasıl yürütür?
DFA tabanlı çalıştırmada geçiş fonksiyonu
\[\delta: Q \times \Sigma \rightarrow Q\]şeklindedir. $Q$ durum kümesini gösterir. Motor girdiyi soldan sağa okur ve her karakter için tablo üzerinden yeni durumu bulur. Metin bittiğinde bulunulan durum kabul kümesi $F$ içindeyse eşleşme başarılıdır.
Aşağıdaki kod, sonu b ile biten ikili dizeleri tanıyan basit bir DFA simülasyonudur:
transitions = {
    "q0": {"a": "q0", "b": "q1"},
    "q1": {"a": "q0", "b": "q1"},
}

def matches(text):
    state = "q0"
    for char in text:
        if char not in transitions[state]:
            return False
        state = transitions[state][char]
    return state == "q1"

print(matches("aabb"))  # True
print(matches("abba"))  # False
Burada q1, en son okunan karakterin b olduğunu hatırlayan kabul durumudur. Makine metnin tamamını saklamaz; yalnızca karar için gereken özeti, yani mevcut durumu tutar. Bu nedenle çalışma süresi $O(n)$, ek durum belleği ise DFA sabitken $O(1)$ olur.
Her regex motoru DFA mıdır?
Hayır. POSIX araçları ve güvenlik odaklı bazı motorlar otomata dayalı çalışırken, birçok popüler motor geri izleme kullanır. Geri referanslar gibi ^(a+)\1$ türü özellikler klasik düzenli dillerin gücünü aşar. Ayrıca kötü tasarlanmış (a+)+b kalıbı geri izlemeli motorlarda üstel süreye ve ReDoS saldırılarına yol açabilir.
Sonlu durum makinelerinin “hatasızlığı”, her girdide tanımlı geçişlerin izlenmesinden ve kabul koşulunun matematiksel olarak belirlenmesinden gelir. Regex böylece sihirli bir metin büyüsü olmaktan çıkar; işlemcinin düzenli, hızlı ve kanıtlanabilir adımlarla oynadığı küçük bir durum oyununa dönüşür.
Yorumlar