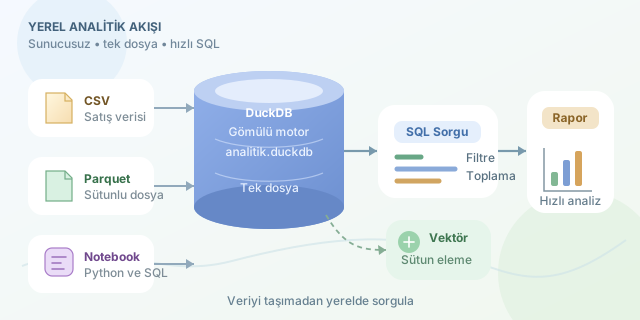
Büyük veri analitiği denince çoğu kişinin aklına sunucular, kümeler ve karmaşık veri boru hatları gelir. DuckDB ise bu algıyı tersine çevirir: Uygulamanızın içinde çalışır, tek bir dosyada veriyi saklar ve milyonlarca satırlık CSV ya da Parquet dosyasında oldukça hızlı SQL sorguları koşturabilir. Özellikle veri bilimi, keşifsel analiz ve yerel raporlama işlerinde “küçük ama çok güçlü” bir araçtır. ``
DuckDB, OLAP (Online Analytical Processing) odaklı, gömülebilir bir ilişkisel veritabanıdır. SQLite ile benzer biçimde ayrı bir veritabanı sunucusu gerektirmez; ancak tasarım hedefi işlem kayıtları değil, sütun bazlı analitik sorgulardır. Örneğin bir e-ticaret uygulamasında tek bir siparişin durumunu güncellemek OLTP problemidir. Buna karşılık, son iki yıldaki siparişlerden kategori, ay ve müşteri segmentine göre ciro analizi yapmak OLAP problemidir.
| Özellik | DuckDB | SQLite | PostgreSQL |
|---|---|---|---|
| Çalışma modeli | Uygulama içine gömülü | Uygulama içine gömülü | İstemci-sunucu |
| Ana kullanım | Analitik sorgular | Hafif işlemsel uygulamalar | Genel amaçlı, çok kullanıcılı sistemler |
| Sütun bazlı yürütme | Evet | Hayır | Kısmen / eklentilerle |
| Parquet ile çalışma | Doğrudan ve güçlü | Harici araç gerekir | Eklenti veya içe aktarma gerekir |
| Dosya tabanlı kullanım | Evet | Evet | Genellikle hayır |
DuckDB’nin hızının önemli bir nedeni vektörleştirilmiş sorgu yürütme yaklaşımıdır. Satırları tek tek işlemek yerine veriyi bloklar hâlinde işler. Ayrıca analitik sorgularda yalnızca gereken sütunları okumaya çalışır. Bir tabloda 40 sütun bulunsa bile sorgu yalnızca tutar ve tarih alanlarını kullanıyorsa, ideal senaryoda diğer sütunların diskten okunmasına gerek kalmaz. Bu davranış, özellikle sütun bazlı Parquet biçiminde çok etkilidir.
Bir satış analizinin temel agregasyon maliyetini kabaca şöyle düşünebiliriz:
\[T \approx O(n \times c)\]Burada $n$ incelenen satır sayısı, $c$ ise okunan sütun sayısıdır. Sütun eleme ve filtre itme (predicate pushdown) teknikleri, hem $n$ hem de $c$ değerini azaltarak gerçek çalışma süresini ciddi biçimde düşürebilir.
Python tarafında başlamak son derece basittir. Aşağıdaki örnek, kalıcı bir veritabanı dosyası açar; CSV verisini tabloya dönüştürür ve aylık ciro raporu üretir:
import duckdb

con = duckdb.connect("analitik.duckdb")

con.execute("""
    CREATE OR REPLACE TABLE satislar AS
    SELECT *
    FROM read_csv_auto('satislar.csv')
""")

rapor = con.execute("""
    SELECT
        date_trunc('month', siparis_tarihi) AS ay,
        kategori,
        ROUND(SUM(tutar), 2) AS ciro,
        COUNT(*) AS siparis_adedi
    FROM satislar
    WHERE siparis_tarihi >= DATE '2025-01-01'
    GROUP BY 1, 2
    ORDER BY ay, ciro DESC
""").fetchdf()

print(rapor)
Bu kodda read_csv_auto, sütun türlerini otomatik tahmin eder. fetchdf() ise sonucu Pandas DataFrame olarak döndürür. Böylece SQL’in ifade gücü ile Python ekosisteminin görselleştirme ve makine öğrenmesi araçları rahatça birleşir.
DuckDB’nin en sevilen yeteneklerinden biri de dosyayı içeri aktarmadan sorgulayabilmesidir. Büyük bir Parquet dosyası için şu sorgu yeterlidir:
SELECT urun_kategorisi, AVG(sepet_tutari) AS ortalama_sepet
FROM read_parquet('veri/siparisler.parquet')
WHERE ulke = 'TR'
GROUP BY urun_kategorisi
ORDER BY ortalama_sepet DESC;
Bu yaklaşım geçici analizlerde depolama maliyetini ve hazırlık süresini azaltır. Yine de DuckDB, yüksek eşzamanlı yazma gerektiren web uygulamalarının ana veritabanı olmak için tasarlanmamıştır. Onu en iyi; veri dosyaları, notebook’lar, ETL görevleri ve yerel dashboard prototipleri arasında çalışan bir analitik motor olarak konumlandırabilirsiniz.
Kısacası DuckDB, “veriyi sunucuya taşımadan analiz etme” fikrini pratikleştirir. SQL biliyorsanız birkaç dakikada üretken olursunuz; Parquet kullanıyorsanız ise yerel makinenizde şaşırtıcı derecede akıcı sorgular elde edebilirsiniz.
Yorumlar