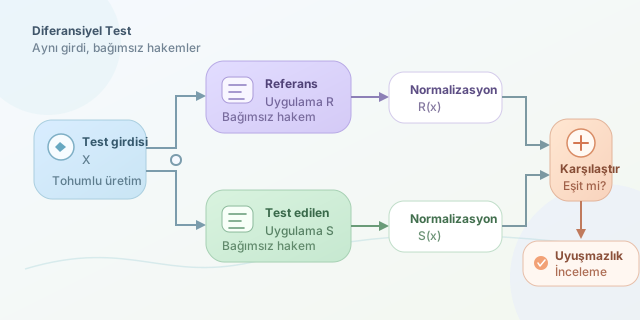
Bir programın sonucunun doğru olup olmadığını her zaman elle hesaplamak kolay değildir. Özellikle derleyiciler, kriptografi araçları, veritabanları veya karmaşık hesaplama kütüphanelerinde beklenen çıktıyı üreten bir test oracle’ı yazmak başlı başına zor bir projeye dönüşür. Diferansiyel test (differential testing), bu sorunu zekice tersine çevirir: Aynı girdiyi benzer görevi yapan iki ya da daha fazla bağımsız yazılıma gönderir, sonra çıktıları karşılaştırır. Sonuçlar ayrışıyorsa ortada araştırmaya değer bir hata, belirsiz spesifikasyon veya uyumsuzluk vardır. ``
Temel varsayım şudur: Bağımsız geliştirilmiş sistemlerin aynı hatayı, aynı koşulda ve aynı biçimde yapma olasılığı düşüktür. Bir referans uygulama $R$, test edilen uygulama $S$ ve girdi kümesi $X$ için ideal durum şöyle ifade edilir:
\[\forall x \in X: \quad normalize(R(x)) = normalize(S(x))\]Buradaki normalize adımı kritiktir. İki araç aynı anlamı farklı metin düzenleriyle üretebilir: JSON alan sırası değişebilir, hata mesajı farklı olabilir veya kayan noktalı sayıların son basamakları ayrışabilir. Bu nedenle ham metni değil, mümkün olduğunda anlamsal çıktıyı karşılaştırmak gerekir. Kayan nokta için örneğin $\vert a-b\vert < \epsilon$ toleransı kullanılabilir.
| Yaklaşım | Beklenen sonuç kaynağı | Güçlü yanı | Zorlayıcı yanı |
|---|---|---|---|
| Birim testi | Geliştiricinin yazdığı oracle | Hata konumunu netleştirir | Oracle yazmak maliyetli olabilir |
| Özellik tabanlı test | Genel kurallar ve invariantlar | Çok sayıda girdi üretir | Her hata özelliğe yansımaz |
| Diferansiyel test | Alternatif uygulamalar | Oracle maliyetini azaltır | Farkın hangisinde hata olduğunu söylemez |
Bu yöntemin klasik kullanım alanlarından biri derleyici testidir. Aynı C programını GCC ve Clang ile derleyip çıktıları çalıştırabilirsiniz. Programın davranışı değişiyorsa derleyicilerden biri hatalı olabilir; fakat C dilindeki tanımsız davranış da güçlü bir şüphelidir. Benzer şekilde bir SQL sorgusunu PostgreSQL ve SQLite üzerinde, bir tarih ayrıştırıcısını farklı dil kütüphanelerinde veya bir görsel sıkıştırıcıyı iki kodlayıcıda deneyebilirsiniz.
Aşağıdaki Python örneği, iki komut satırı aracının JSON çıktısını anlamsal olarak karşılaştırır. Amaç araçların metin biçimini değil, ürettikleri veri yapısını değerlendirmektir:
import json
import subprocess


def run(command, payload):
    result = subprocess.run(
        command,
        input=json.dumps(payload),
        text=True,
        capture_output=True,
        check=True,
    )
    return json.loads(result.stdout)


def normalize(data):
    # Sözlük anahtarlarını karşılaştırma sırasında etkisiz kılar.
    return json.dumps(data, sort_keys=True, ensure_ascii=False)

payload = {"date": "2026-08-12", "timezone": "Europe/Istanbul"}
a = run(["./parser_a"], payload)
b = run(["./parser_b"], payload)

if normalize(a) != normalize(b):
    print("Uyuşmazlık bulundu!")
    print("A:", a)
    print("B:", b)
Elbette her fark gerçek bir bug değildir. Spesifikasyonun açık bırakıldığı noktalar, sürüm farklılıkları, platform bağımlılığı ve rastgelelik yanlış alarm üretebilir. Bu yüzden test girdilerini kaydetmek, tohum (seed) kullanmak, sürümleri sabitlemek ve farkları yeniden üretilebilir hâle getirmek gerekir. Bulunan vakayı daha küçük bir girdiye indirmek için test-case reduction uygulanması da hata raporunu geliştiriciler için çok daha değerli yapar.
Diferansiyel test en iyi, farklı uygulamaların gerçekten bağımsız olduğu durumda çalışır. Aynı kütüphaneyi kullanan iki araç görünüşte iki ayrı hakemdir ama aynı ortak hatayı taşıyabilir. Buna rağmen iyi tasarlanmış girdi üretimi, doğru normalizasyon ve dikkatli incelemeyle bu teknik; sıradan testlerin göremediği gizli uyumsuzlukları ortaya çıkaran son derece etkili bir kalite güvence aracıdır.
Yorumlar