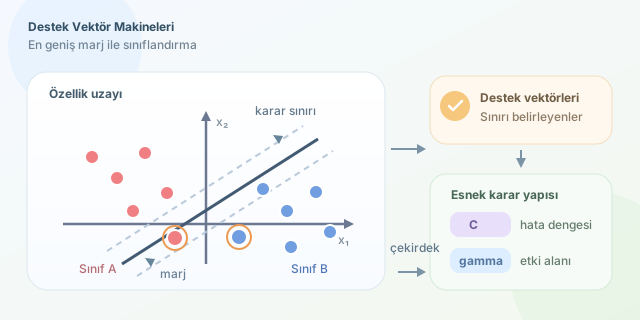
Destek Vektör Makineleri (Support Vector Machines, SVM), iki ya da daha fazla sınıfı ayırırken yalnızca bir çizgi çizmekle yetinmeyen klasik bir makine öğrenmesi algoritmasıdır. Temel hedefi, sınıflar arasındaki en güvenli koridoru, yani en geniş marjı bulmaktır. Bir tarafta kırmızı noktalar, diğer tarafta mavi noktalar olduğunu düşünün: SVM, iki grubun arasından geçen ve her iki gruba da olabildiğince uzak duran sınırı seçmeye çalışır. Bu yaklaşım, modelin yeni ve görülmemiş verilerde daha dayanıklı kararlar vermesine yardım eder. ``
Bir doğrusal SVM için karar sınırı şu denklemle ifade edilir:
\[w^T x + b = 0\]Burada $x$ giriş özelliklerini, $w$ sınırın yönünü belirleyen ağırlık vektörünü, $b$ ise sınırın konumunu temsil eder. Bir örneğin hangi sınıfa ait olduğuna karar vermek için işaret fonksiyonu kullanılır:
\[\hat{y} = \operatorname{sign}(w^T x + b)\]SVM’nin sihri, bu sınırın iki yanındaki en yakın örneklerde saklıdır. Bu kritik gözlemlere destek vektörleri denir. Sınırın çok uzağındaki yüzlerce veri noktası değişse bile model çoğu zaman aynı kalabilir; ama bir destek vektörünün yeri değişirse karar sınırı da değişebilir. Adeta ipi gergin tutan birkaç kilit nokta vardır.
Marj genişliği yaklaşık olarak $\frac{2}{\Vert w\Vert }$ ile ilişkilidir. Dolayısıyla en geniş marjı aramak, matematiksel olarak $\Vert w\Vert $ değerini küçültmeye dönüşür. Veriler kusursuz ayrılabiliyorsa SVM şu optimizasyon fikrini izler:
\[\min_{w,b} \frac{1}{2}\Vert w\Vert ^2 \quad \text{koşuluyla} \quad y_i(w^T x_i+b) \geq 1\]Gerçek hayat verileri ise nadiren usludur. Bir spam e-postası normal e-postaya, bir tümör ölçümü de sağlıklı örneğe benzeyebilir. Bu durumda soft margin yaklaşımı devreye girer. $C$ parametresi, geniş marj isteği ile eğitim hatalarını cezalandırma isteği arasındaki dengeyi kurar.
| Kavram | Ne yapar? | Aşırı büyük olduğunda |
|---|---|---|
| $C$ | Hatalı sınıflandırmaları ne kadar cezalandıracağını belirler | Model gürültüye fazla uyabilir |
gamma |
RBF çekirdeğinde tek bir noktanın etki alanını belirler | Çok karmaşık, kıvrımlı sınırlar oluşabilir |
| Kernel | Veriyi dolaylı olarak daha yüksek boyuta taşır | Hesaplama maliyeti artabilir |
Doğrusal bir çizgi yeterli olmadığında SVM, çekirdek hilesi (kernel trick) kullanır. Veriyi gerçekten yüksek boyutlu bir uzaya taşımak yerine, iki noktanın o uzaydaki benzerliğini doğrudan hesaplar. En yaygın seçeneklerden RBF çekirdeği şöyledir:
\[K(x,z)=\exp(-\gamma \Vert x-z\Vert ^2)\]Bu sayede dairesel, kıvrımlı veya daha karmaşık ayrımlar yakalanabilir. Ancak çekirdek seçimi ve hiperparametre ayarı dikkat ister.
| Yöntem | Güçlü yanı | Sınırlaması |
|---|---|---|
| Doğrusal SVM | Hızlı, yüksek boyutlu metin verilerinde başarılı | Karmaşık ilişkileri kaçırabilir |
| RBF SVM | Doğrusal olmayan örüntüleri yakalar | C ve gamma ayarı hassastır |
| Karar Ağacı | Açıklaması kolaydır | Küçük veri değişimlerine duyarlı olabilir |
Python’da scikit-learn ile temel bir RBF SVM eğitmek oldukça kısadır. Aşağıdaki örnek, ölçekleme yapar; çünkü SVM uzaklıklara duyarlıdır ve büyük ölçekli bir özellik diğerlerini haksız biçimde bastırabilir.
from sklearn.datasets import load_iris
from sklearn.model_selection import train_test_split
from sklearn.pipeline import make_pipeline
from sklearn.preprocessing import StandardScaler
from sklearn.svm import SVC
from sklearn.metrics import accuracy_score

X, y = load_iris(return_X_y=True)
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.25, random_state=42, stratify=y
)

model = make_pipeline(StandardScaler(), SVC(kernel="rbf", C=2.0, gamma="scale"))
model.fit(X_train, y_train)
predictions = model.predict(X_test)

print("Doğruluk:", accuracy_score(y_test, predictions))
Özetle SVM, özellikle özellik sayısının örnek sayısından fazla olduğu metin sınıflandırma, biyoinformatik ve küçük-orta ölçekli veri kümelerinde güçlü bir adaydır. İyi bir ölçekleme, çapraz doğrulama ve dikkatli C/gamma aramasıyla bu klasik algoritma hâlâ oldukça modern sonuçlar üretebilir.
Yorumlar