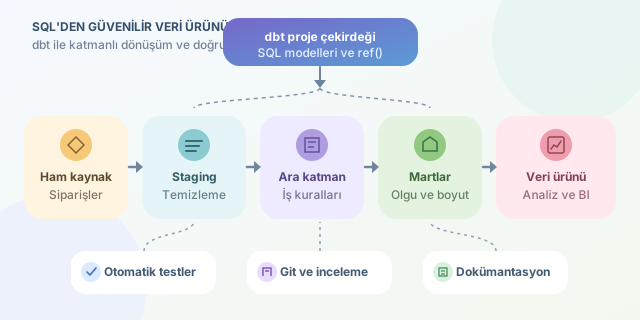
Modern veri ekiplerinde asıl zorluk, veriyi depoya taşımaktan çok onu güvenilir, anlaşılır ve yeniden üretilebilir biçimde dönüştürmektir. dbt (data build tool), bu problemi SQL dönüşümlerini yazılım geliştirme disiplinleriyle birleştirerek çözer. Böylece karmaşık ETL betikleri yerine Git ile izlenen modeller, testler, dokümantasyon ve bağımlılık grafikleriyle yönetilen bir veri platformu elde edersiniz. ``
dbt’nin temel fikri oldukça sade: Ham tabloları kaynak kabul edin, iş kurallarını küçük SQL modellerine bölün ve bu modellerin çalışma sırasını bağımlılıklardan türetin. Örneğin stg_orders modeli ham sipariş verisini temizler; fct_orders ise temizlenmiş veriden analiz için hazır bir olgu tablosu üretir. Bir model diğerini ref() ile çağırdığında dbt yalnızca SQL metnini birleştirmez; veri soy ağacını (lineage) da kaydeder.
Bu yaklaşımda dönüşüm maliyetini kabaca şöyle düşünebiliriz:
\[T_{toplam} = T_{geliştirme} + T_{hata\_bulma} + T_{bakım}\]Başlangıçta modelleme ve test yazma için küçük bir yatırım yapılır. Ancak standartlaşmış katmanlar, otomatik testler ve kod incelemeleri sayesinde $T_{hata_bulma}$ ile $T_{bakım}$ zamanla önemli ölçüde azalır. dbt, SQL bilen analistlerin de veri mühendisliği ilkelerine daha yakın çalışmasını sağlar; bu yüzden yaklaşım sıkça analytics engineering olarak anılır.
| Geleneksel dönüşüm | dbt yaklaşımı |
|---|---|
| Dönüşüm mantığı tek ve büyük betiklerde yaşar | Mantık küçük, bağımsız SQL modellerine ayrılır |
| Değişiklik geçmişi belirsiz olabilir | Git commit, branch ve pull request ile izlenir |
| Veri kalitesi çoğunlukla manuel kontrol edilir | Şema ve özel testlerle otomatik doğrulanır |
| Dokümantasyon ayrı yerde ve güncelliğini kaybedebilir | Dokümantasyon kodla birlikte üretilir |
| Çalışma sırası elle yönetilir | ref() bağımlılık grafiğini otomatik kurar |
Pratikte iyi bir dbt projesi genellikle katmanlı tasarlanır. staging katmanı kaynak alan adlarını normalize eder ve tip dönüşümlerini yapar. intermediate katmanı karmaşık ara iş kurallarını izole eder. marts katmanı ise BI araçlarının ve veri tüketicilerinin kullanacağı boyut ve olgu tablolarını sunar. Bu ayrım, aynı hesaplamayı farklı raporlarda tekrar etmek yerine tek bir güvenilir tanım oluşturur.
Aşağıdaki model, ham siparişlerden tamamlanmış siparişleri seçer. ref() kullanımı, tablo adını doğrudan yazmaktan daha güvenlidir: Ortam değişse bile dbt doğru bağımlılığı derler.
-- models/marts/fct_orders.sql
select
    order_id,
    customer_id,
    cast(order_date as date) as order_date,
    amount,
    amount * 0.20 as estimated_tax
from {{ ref('stg_orders') }}
where status = 'completed'
Bu modelin yalnızca çalışması yeterli değildir; beklenen kuralları da sağlamalıdır. Örneğin sipariş kimliği boş olmamalı ve tekrar etmemelidir. YAML ile tanımlanan testler, veri sözleşmesi gibi davranır:
version: 2
models:
  - name: fct_orders
    columns:
      - name: order_id
        tests:
          - not_null
          - unique
      - name: amount
        tests:
          - not_null
dbt run modelleri üretirken, dbt test bu varsayımları çalıştırır. Sürekli entegrasyon hattında her pull request için dbt build koşturmak, hatalı dönüşümlerin ana dala ulaşmasını engeller. Özellikle kaynak şeması değiştiğinde bu kontrol, sessizce bozulan dashboard’lara karşı güçlü bir emniyet kemeridir.
Versiyon kontrolü burada yalnızca dosya yedekleme aracı değildir. Branch’ler deneysel metrikleri izole eder, pull request’ler finans veya ürün ekiplerinin iş kuralını incelemesini sağlar, commit geçmişi ise “net gelir neden geçen ay değişti?” sorusuna teknik bir yanıt verir. Üretim ortamında kullanılan mantık ile depodaki kodun eşleşmesi, denetlenebilirlik açısından kritiktir.
Başlangıç için küçük ilerleyin: Önce bir ham kaynağı source olarak tanımlayın, ardından tek bir staging modeli ve iki temel test ekleyin. Sonra en çok kullanılan raporu bir mart modeline taşıyın. dbt’nin gerçek gücü, devasa bir SQL dosyasından değil; okunabilir modeller, açık bağımlılıklar ve test edilebilir iş kurallarından doğar. Veri dönüşümünüz böylece gizemli bir arka plan işi olmaktan çıkar, ekipçe geliştirilen bir veri ürününe dönüşür.
Yorumlar