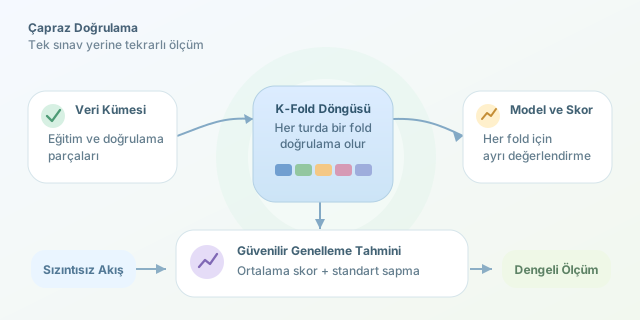
Bir makine öğrenmesi modelinin eğitim verisinde yüksek doğruluk vermesi, onun gerçek dünyada da başarılı olacağı anlamına gelmez. Model belki gerçekten örüntüyü öğrenmiştir; belki de eğitim kümesini ezberlemiştir. Cross validation (çapraz doğrulama), bu ikisini ayırmak için veriyi akıllıca ve tekrarlanabilir biçimde bölerek modelin genelleme yeteneğini ölçer. Kısacası, tek bir sınav yerine modeli birden fazla sınava sokar. ``
Temel problem şudur: Elimizdeki veri sonludur ve performans ölçümümüz bu örnekleme bağlıdır. Eğitim kümesindeki hata $E_{train}$ çoğu zaman iyimserdir. Asıl hedef, modelin daha önce görmediği verideki beklenen hatasını, yani genelleme hatasını tahmin etmektir:
\[E_{gen}=\mathbb{E}_{(x,y)\sim \mathcal{D}}[L(y,\hat{f}(x))]\]Burada $L$, kayıp fonksiyonunu; $\mathcal{D}$ ise gerçek fakat tam olarak bilmediğimiz veri dağılımını temsil eder. Cross validation, elimizdeki sınırlı veriyle $E_{gen}$ için daha dengeli bir tahmin üretmeye çalışır.
En yaygın teknikler
| Teknik | İşleyiş | Güçlü yanı | Dikkat edilmesi gereken |
|---|---|---|---|
| Hold-out | Veri eğitim/doğrulama olarak bir kez ayrılır | Hızlı ve basit | Bölünme şansa fazla bağlıdır |
| K-Fold | Veri $k$ parçaya ayrılır, her parça sırayla doğrulanır | Dengeli, yaygın tercih | Hesaplama maliyeti artar |
| Stratified K-Fold | K-Fold, sınıf oranlarını koruyarak yapılır | Dengesiz sınıflarda güvenilir | Genellikle sınıflandırmaya özeldir |
| Leave-One-Out | Her turda tek gözlem test edilir | Veriyi maksimum kullanır | Büyük veride çok yavaştır |
| Time Series Split | Gelecek verisi geçmişe sızdırılmaz | Zaman serilerinde gerçekçidir | Klasik karıştırma uygulanamaz |
K-Fold yaklaşımında veri $k$ eşit parçaya, yani fold’a bölünür. Her turda bir fold doğrulama için ayrılır, kalan $k-1$ fold ile eğitim yapılır. Sonuçta $k$ farklı skor elde edilir. Ortalama skor şöyle hesaplanır:
\[\bar{s}=\frac{1}{k}\sum_{i=1}^{k}s_i\]Yalnızca ortalamaya bakmak yeterli değildir. Skorların standart sapması yüksekse modelin performansı veri alt kümelerine karşı kırılgan olabilir. Örneğin $0.90 \pm 0.01$ sonuç veren model, $0.91 \pm 0.08$ veren modelden çoğu senaryoda daha öngörülebilirdir.
Python ile Stratified K-Fold
Aşağıdaki örnek, sınıflandırma probleminde sınıf oranlarını her fold içinde korur. Özellikle dolandırıcılık tespiti gibi pozitif sınıfın az olduğu veri setlerinde bu ayrıntı kritik önemdedir.
from sklearn.model_selection import StratifiedKFold, cross_val_score
from sklearn.pipeline import make_pipeline
from sklearn.preprocessing import StandardScaler
from sklearn.linear_model import LogisticRegression

model = make_pipeline(
    StandardScaler(),
    LogisticRegression(max_iter=1000)
)

cv = StratifiedKFold(n_splits=5, shuffle=True, random_state=42)
scores = cross_val_score(model, X, y, cv=cv, scoring="f1")

print(f"Ortalama F1: {scores.mean():.3f}")
print(f"Standart sapma: {scores.std():.3f}")
Burada Pipeline kullanımı tesadüf değildir. Ölçekleme işlemi fold dışındaki veriyi görürse veri sızıntısı (data leakage) oluşur. Pipeline, her eğitim turunda StandardScaler nesnesini yalnızca o turun eğitim parçasında öğrenir; doğrulama parçasına aynı dönüşümü uygular. Böylece sınav sorularını önceden görmüş bir model üretmemiş olursunuz.
Doğru yöntemi seçmek
Sınıflandırmada sınıf dağılımı dengesizse StratifiedKFold, gruplar birbirine bağımlıysa GroupKFold, zaman bağımlılığı varsa TimeSeriesSplit tercih edilmelidir. Hiperparametre seçimi yaparken daha da dikkatli olmak gerekir: Aynı fold’larda defalarca ayar deneyip en yüksek skoru seçmek doğrulama verisine dolaylı ezber yaratabilir. Bu nedenle dış döngüde performansı ölçen, iç döngüde parametre seçen nested cross validation daha dürüst bir yaklaşımdır.
Sonuç olarak cross validation sihirli bir doğruluk makinesi değil, güvenilir deney tasarımı aracıdır. Doğru bölme stratejisi, uygun metrik ve sızıntısız bir pipeline birleştiğinde modelinizin üretimdeki gerçek performansına çok daha sağlam yaklaşabilirsiniz.
Yorumlar