İçindekiler
Modern işlemciler inanılmaz hızlıdır; fakat RAM erişimi, işlemci çekirdeğinin hızına kıyasla şaşırtıcı derecede yavaştır. Bu yüzden performans darboğazı çoğu zaman karmaşık matematiksel işlem değil, verinin bellekte nerede durduğu ve hangi sırayla okunduğudur. Cache dostu kod yazımı; veriyi işlemcinin sevdiği biçimde, yakın adreslerde ve öngörülebilir bir akışla tüketme sanatıdır. ``
Cache hiyerarşisi: Hız ile kapasitenin pazarlığı
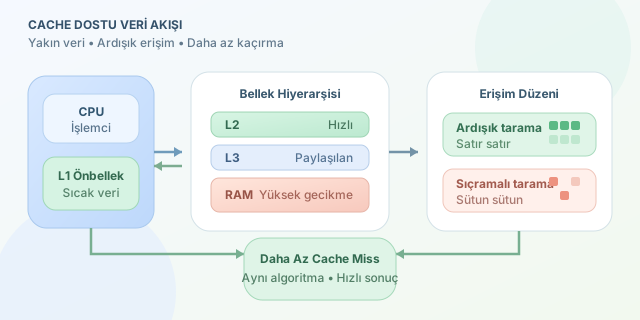
CPU, RAM’den her değişkeni tek tek getirmek istemez. Bunun yerine belleği genellikle cache line adı verilen, çoğu mimaride 64 baytlık bloklar hâlinde taşır. Bir dizi elemanına eriştiğinizde, komşu elemanlar da aynı anda cache’e gelme eğilimindedir. Buna uzamsal yerellik denir.
İşlemci ayrıca yakın zamanda kullandığı verinin tekrar kullanılacağını varsayar. Bu da zamansal yerellik ilkesidir. L1 cache çok küçük ama aşırı hızlıdır; L3 ise daha büyük fakat nispeten yavaştır. RAM’e düşmek ise performansın moralini bozan olaydır.
| Bellek katmanı | Tipik kapasite | Göreli gecikme | En uygun kullanım |
|---|---|---|---|
| L1 Cache | KB mertebesi | Çok düşük | Sık kullanılan sıcak veri |
| L2 Cache | Yüzlerce KB/MB | Düşük | Yerel çalışma kümeleri |
| L3 Cache | MB mertebesi | Orta | Çekirdekler arası paylaşılan veri |
| RAM | GB mertebesi | Yüksek | Büyük veri kümeleri |
Basitleştirilmiş maliyet modeliyle toplam süre şöyle düşünülebilir:
\[T \approx N \cdot C_{işlem} + M \cdot P_{cache\ miss}\]Burada $N$ işlem sayısını, $M$ cache kaçırma sayısını temsil eder. İşlem maliyeti küçükken $M$ artarsa, teorik olarak aynı karmaşıklıktaki iki kod arasında devasa fark oluşur.
Satır satır mı, sütun sütun mu?
C/C++ gibi dillerde iki boyutlu diziler satır-major düzende saklanır. Yani aynı satırdaki elemanlar bellekte yan yanadır. Bu nedenle dış döngünün satır, iç döngünün sütun olması cache için doğal akıştır.
constexpr int N = 2048;
int matrix[N][N];
long long sum = 0;

// Cache dostu: ardışık bellek adreslerine ilerler.
for (int row = 0; row < N; ++row) {
    for (int col = 0; col < N; ++col) {
        sum += matrix[row][col];
    }
}
Buna karşılık aşağıdaki sürüm, her adımda bellekte büyük sıçramalar yapar. Her erişim farklı bir cache line getirebilir:
// Aynı sonuç, fakat zayıf bellek erişim düzeni.
for (int col = 0; col < N; ++col) {
    for (int row = 0; row < N; ++row) {
        sum += matrix[row][col];
    }
}
Her iki örneğin de zaman karmaşıklığı $O(N^2)$’dir. Ancak Big-O, sabit maliyetleri ve cache miss bedelini gizler. Gerçek dünyada hızlı olan kod, yalnızca daha az işlem yapan değil, belleğe daha akıllı ulaşandır.
Veri yapısı seçimi de performans kararıdır
Nesne yönelimli tasarımda sıkça görülen Array of Structures (AoS) yaklaşımı, tüm alanları yan yana tutar. Eğer yalnızca konum güncellemesi yapıyorsanız renk ve kimlik alanlarını da gereksiz yere cache’e taşırsınız. Structure of Arrays (SoA) ise aynı tür verileri ardışık tutar.
| Düzen | Güçlü yanı | Riskli senaryo |
|---|---|---|
| AoS | Tek bir nesnenin tüm alanları birlikte kullanılıyorsa | Sadece tek alan üzerinde toplu işlem |
| SoA | Vektörleştirme ve ardışık tarama için ideal | Nesne alanları sürekli birlikte okunuyorsa |
Örneğin oyun motorunda binlerce parçacığın yalnızca x ve velocityX değerini güncelliyorsanız, SoA düzeni daha az gereksiz veri taşır.
Pratik kontrol listesi
Önce profil çıkarın; tahminle optimizasyon yapmak pahalı bir hobidir. Ardından bağlı listeler yerine mümkünse vector gibi ardışık yapıları tercih edin, gereksiz pointer takibini azaltın ve büyük matris işlemlerinde blocking/tiling uygulayın. Tiling, veri parçasını L1 veya L2 cache’e sığacak bloklarda işleyerek tekrar kullanım oranını yükseltir.
Cache dostu yaklaşım sihir değil; işlemcinin veri taşıma alışkanlıklarıyla iş birliğidir. Algoritmanızın matematiği değişmese bile veriyi doğru sırada gezmek, saniyeleri milisaniyelere çevirebilir.
Yorumlar