İçindekiler
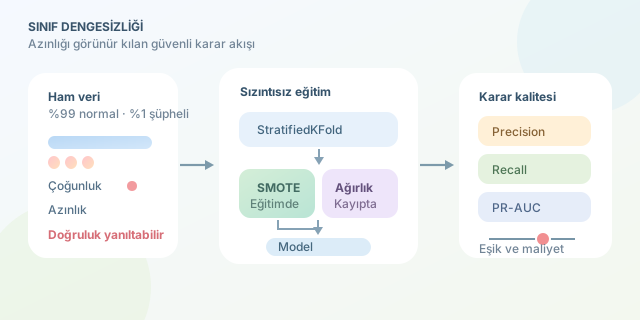
Bir dolandırıcılık tespit veri setinde işlemlerin %99’u normal, yalnızca %1’i şüpheli olabilir. Model her kayda “normal” diyerek %99 doğruluk elde eder; fakat asıl yakalamamız gereken vakaları tamamen kaçırır. İşte class imbalance (sınıf dengesizliği), başarı metriğinin alkış aldığı ama ürünün başarısız olduğu bu yanıltıcı sahnenin adıdır. Sorun sadece veri sayısı değil, modelin eğitim sırasında çoğunluk sınıfının hatalarını daha sık görmesi ve kayıp fonksiyonunun bu sınıfa doğal olarak daha fazla ağırlık vermesidir.
``
Neden doğruluk tek başına yetmez?
İkili sınıflandırmada temel karışıklık matrisi; doğru pozitif (TP), yanlış pozitif (FP), doğru negatif (TN) ve yanlış negatiften (FN) oluşur. Accuracy aşağıdaki gibi hesaplanır:
\[Accuracy = \frac{TP + TN}{TP + TN + FP + FN}\]Ancak nadir olaylarda devasa bir $TN$ değeri, kötü bir modeli iyi gösterebilir. Bu nedenle azınlık sınıfına odaklanan precision, recall ve $F1$ skoru daha anlamlıdır:
\[Precision = \frac{TP}{TP+FP}, \qquad Recall = \frac{TP}{TP+FN}\] \[F1 = 2 \cdot \frac{Precision \cdot Recall}{Precision + Recall}\]| Metrik | Sorduğu soru | Dengesiz veride kullanım |
|---|---|---|
| Accuracy | Toplamda kaç tahmin doğru? | Tek başına risklidir |
| Precision | Alarm verdiklerimin kaçı gerçekten pozitif? | Yanlış alarm maliyetliyse önemlidir |
| Recall | Gerçek pozitiflerin kaçını buldum? | Hastalık ve dolandırıcılıkta kritiktir |
| PR-AUC | Eşikler boyunca precision-recall dengesi nedir? | Nadir pozitifler için güçlü tercihtir |
Örneğin kanser taramasında FN maliyeti yüksek olduğundan recall yükseltmek önceliklidir. Spam filtresinde ise gerçek e-postayı spam diye işaretlemek pahalı olduğundan precision korunmalıdır. Yani “en iyi model”, iş hedefinin hata maliyetine göre değişir.
Veri düzeyinde dengeleme stratejileri
İlk yaklaşım undersampling ile çoğunluk sınıfından örnek azaltmaktır. Eğitim hızlanır, fakat değerli bilgi silinebilir. Oversampling ise azınlık örneklerini çoğaltır; basit kopyalama aşırı öğrenme riskini artırabilir. SMOTE, azınlık örneklerinin komşuları arasında sentetik noktalar üretir:
\[x_{new} = x_i + \lambda(x_{nn} - x_i), \quad \lambda \in [0,1]\]| Yöntem | Avantaj | Dikkat edilmesi gereken |
|---|---|---|
| Random undersampling | Hızlı ve basit | Çoğunluk bilgisini kaybedebilir |
| Random oversampling | Veri kaybı yok | Kopyalara ezber oluşabilir |
| SMOTE | Daha zengin azınlık uzayı | Gürültülü bölgelerde sentetik hata üretebilir |
| Class weight | Veriyi değiştirmez | Ağırlıklar deneysel ayarlanmalıdır |
Çok kritik kural: yeniden örnekleme işlemini tüm veri setine değil, yalnızca eğitim katmanına uygulayın. Aksi halde test verisine sentetik olarak “sızan” bilgi, ölçümü yapay biçimde iyileştirir. Bunun güvenli yolu, işlemleri bir pipeline içinde çapraz doğrulamayla çalıştırmaktır.
from imblearn.pipeline import Pipeline
from imblearn.over_sampling import SMOTE
from sklearn.linear_model import LogisticRegression
from sklearn.model_selection import StratifiedKFold, cross_val_score

pipeline = Pipeline([
    ("smote", SMOTE(random_state=42)),
    ("model", LogisticRegression(class_weight="balanced", max_iter=1000))
])

cv = StratifiedKFold(n_splits=5, shuffle=True, random_state=42)
scores = cross_val_score(pipeline, X, y, cv=cv, scoring="average_precision")
print(scores.mean())
Bu örnekte StratifiedKFold, her katmanda sınıf oranını korur. SMOTE sadece ilgili eğitim bölümünde çalışır; average_precision ise PR eğrisini özetleyerek nadir sınıf performansını değerlendirir.
Model ve eşik ayarı
Ağaç tabanlı modellerde class_weight="balanced", her sınıfın kayıptaki etkisini ters frekansla artırır. Yaklaşık olarak sınıf ağırlığı $w_c \propto 1/n_c$ kabul edilebilir. Bunun yanında varsayılan $0.5$ karar eşiği kutsal değildir. Recall artırmak için eşiği düşürür, precision artırmak için yükseltirsiniz. Son kararı validation kümesindeki maliyet, PR eğrisi ve gerçek operasyon kapasitesiyle verin.
Sonuç olarak tek bir “sihirli SMOTE” düğmesi yoktur. Doğru metrik, sızıntısız değerlendirme, uygun maliyet ağırlıkları ve bilinçli eşik seçimi birlikte çalıştığında azınlık sınıfı artık veri setinin sessiz kahramanı olmaktan çıkar.
Yorumlar