İçindekiler
Bir makine öğrenmesi modelinin eğitim verisinde harika sonuç vermesi, henüz gerçek dünyada da başarılı olacağı anlamına gelmez. Asıl soru şudur: Model, daha önce hiç görmediği örneklerde ne kadar iyi çalışır? Çapraz doğrulama (cross-validation), veriyi akıllıca parçalara ayırarak bu soruya daha güvenilir bir yanıt üretir. Tek bir eğitim-test ayrımının şansına güvenmek yerine, modelin farklı veri dilimlerindeki tutarlılığını ölçer.
``
Neden tek bir test bölmesi yeterli olmayabilir?
Klasik yaklaşımda veri; eğitim ve test kümelerine bölünür. Örneğin verinin %80’i eğitim, %20’si test için ayrılır. Ancak küçük veya dengesiz veri setlerinde test kümesine düşen örnekler sonucu dramatik biçimde değiştirebilir. Bir bölmede kolay örnekler, diğerinde zor örnekler bulunabilir. Bu durum, değerlendirme skorunda yüksek varyans yaratır.
Model performansını kabaca şöyle düşünebiliriz:
\[\text{Genelleme Hatası} = \text{Bias}^2 + \text{Varyans} + \text{Gürültü}\]Çapraz doğrulama doğrudan modeli değiştirmez; fakat performans tahminindeki belirsizliği azaltır. Her turda farklı bir parça test edildiği için tek bir şanslı bölünmeye bağımlılık azalır. Böylece yalnızca ortalama başarıyı değil, başarıdaki oynaklığı da görürüz.
| Yaklaşım | Güçlü yönü | Riski | Uygun kullanım |
|---|---|---|---|
| Hold-out bölme | Çok hızlıdır | Bölünmeye aşırı bağımlıdır | Büyük veri setleri |
| K-Fold | Daha dengeli ölçüm sunar | Eğitim maliyeti artar | Genel amaçlı modeller |
| Leave-One-Out | Verinin neredeyse tamamını eğitime ayırır | Çok yavaştır, varyansı yüksek olabilir | Çok küçük veri setleri |
| Time Series Split | Zaman sırasını korur | Her veri için uygun değildir | Tahmin ve finans verileri |
K-Fold: Sırayla test et, ortalamayı al
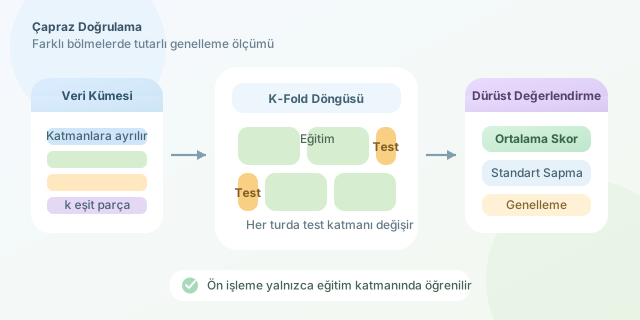
En yaygın yöntem olan K-Fold çapraz doğrulamada veri, yaklaşık eşit büyüklükte $k$ parçaya ayrılır. Model $k$ kez eğitilir. Her turda bir parça doğrulama için ayrılır, kalan $k-1$ parça eğitimde kullanılır. Nihai skor genellikle tüm turlardaki skorların ortalamasıdır:
\[\bar{s} = \frac{1}{k}\sum_{i=1}^{k}s_i\]Örneğin $k=5$ ise model beş ayrı deneyden geçer. Ortalama doğruluk %89, standart sapma %4 ise modelin sonucu yalnızca “%89” değildir; farklı örneklemlerde gözle görülür bir dalgalanma vardır. Bu bilgi, model seçerken son derece değerlidir.
from sklearn.datasets import load_iris
from sklearn.linear_model import LogisticRegression
from sklearn.model_selection import StratifiedKFold, cross_val_score

X, y = load_iris(return_X_y=True)
model = LogisticRegression(max_iter=500)

cv = StratifiedKFold(n_splits=5, shuffle=True, random_state=42)
scores = cross_val_score(model, X, y, cv=cv, scoring="accuracy")

print(f"Katman skorları: {scores}")
print(f"Ortalama: {scores.mean():.3f}")
print(f"Standart sapma: {scores.std():.3f}")
Bu örnekte StratifiedKFold, her katmanda sınıf oranlarını mümkün olduğunca korur. Özellikle sınıflandırma problemlerinde bu kritik bir ayrıntıdır: %95 negatif, %5 pozitif örnek içeren bir veri setinde rastgele bölme bazı katmanları pozitif örneksiz bırakabilir.
Hangi tekniği ne zaman seçmelisiniz?
| Veri durumu | Önerilen teknik | Neden? |
|---|---|---|
| Sınıflar dengesiz | Stratified K-Fold | Sınıf oranlarını korur |
| Aynı kullanıcıdan çok kayıt var | GroupKFold | Kullanıcı sızıntısını önler |
| Zaman bağımlılığı var | TimeSeriesSplit | Geleceğin geçmişe sızmasını engeller |
| Veri çok küçük | K-Fold veya dikkatli LOOCV | Eğitim verisini verimli kullanır |
En tehlikeli hata, ön işleme adımlarını çapraz doğrulamadan önce tüm veri üzerinde yapmaktır. Ölçekleme, özellik seçimi veya eksik değer doldurma işlemleri eğitim katmanı içinde öğrenilmelidir. Bunun için Pipeline kullanmak veri sızıntısını engeller. Unutmayın: çapraz doğrulamanın amacı yüksek skor bulmak değil, modelinizin bilinmeyen verideki davranışını dürüstçe tahmin etmektir.
Yorumlar