İçindekiler
Bir Python dosyasının, Java sınıfının veya C# projesinin ekranda sonuç üretmesi ilk bakışta sihir gibi görünebilir. Oysa kaynak kod ile işlemcinin anlayabildiği makine komutları arasında oldukça düzenli bir ara dünya vardır: bytecode ve onu çalıştıran sanal makine (VM). Bu ikili, farklı işletim sistemlerinde tutarlı davranış sağlamanın ve geliştirici deneyimini iyileştirmenin güçlü yollarından biridir.
``
Üç dil, üç komut seviyesi
Bilgisayar işlemcisi doğrudan if, for veya class kavramlarını bilmez. CPU’nun anlayabildiği şey, mimariye özgü ikili komutlardır. Örneğin x86-64 için üretilen bir makine kodu, ARM tabanlı bir telefonda doğrudan çalışmaz. Bytecode ise kaynak kod ile bu fiziksel makine kodu arasındaki taşınabilir ara gösterimdir.
| Seviye | Örnek | Kim çalıştırır? | Taşınabilirlik |
|---|---|---|---|
| Kaynak kod | print(x + 1) |
Derleyici veya yorumlayıcı | Yüksek |
| Bytecode | LOAD x, ADD 1 |
Sanal makine | Yüksek |
| Makine kodu | CPU opcodları | İşlemci | Düşük |
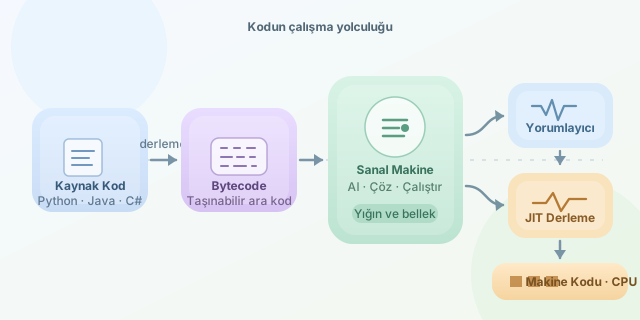
Bu yolculuk basitleştirilmiş biçimde şöyle yazılabilir:
\[\text{Kaynak Kod} \xrightarrow{\text{derleme}} \text{Bytecode} \xrightarrow{\text{VM}} \text{Makine Kodu / İşlem}\]Java’da javac, .java dosyasını .class bytecode’una dönüştürür. Ardından JVM bu bytecode’u çalıştırır. Python’da da CPython çoğu durumda kaynak dosyayı önce .pyc biçimindeki bytecode’a dönüştürür; sonra Python sanal makinesi komutları yürütür.
Sanal makine tam olarak ne yapar?
VM, bytecode komutlarını okuyup etkilerini uygular. Basit bir stack tabanlı VM düşünelim. 2 + 3 işlemi için bytecode önce değerleri yığına koyar, ardından toplama komutu onları yığından çeker:
PUSH 2
PUSH 3
ADD
PRINT
Bu komutları çalıştıran minimal bir yorumlayıcı fikri Python ile şöyledir:
stack = []

for instruction in program:
    op, *args = instruction.split()

    if op == "PUSH":
        stack.append(int(args[0]))
    elif op == "ADD":
        right = stack.pop()
        left = stack.pop()
        stack.append(left + right)
    elif op == "PRINT":
        print(stack.pop())
Buradaki kod, gerçek JVM kadar karmaşık değildir; fakat temel prensibi gösterir: VM bir fetch-decode-execute döngüsü kurar. Komutu alır, ne anlama geldiğini çözer ve ilgili işlemi uygular. Gerçek VM’ler buna bellek yönetimi, güvenlik denetimleri, istisnalar, iş parçacıkları ve çöp toplayıcı gibi yetenekler ekler.
Yorumlama mı, JIT mi?
Bytecode her zaman tek tek yorumlanmak zorunda değildir. Modern VM’ler sık çalışan kodları belirleyip onları çalışma anında makine koduna dönüştürebilir. Bu yaklaşım Just-In-Time (JIT) derleme olarak adlandırılır.
| Yaklaşım | Avantaj | Dezavantaj |
|---|---|---|
| Salt yorumlama | Hızlı başlangıç, basit tasarım | Döngülerde daha yavaş olabilir |
| Önceden derleme (AOT) | Güçlü başlangıç performansı | Platform başına çıktı gerekir |
| JIT derleme | Çalışma verisine göre optimizasyon | Isınma süresi ve ek bellek |
JIT’in temel fikri, en sık kullanılan yolları optimize etmektir. Bir fonksiyonun çalışma maliyetini kabaca şöyle düşünebiliriz:
\[T_{toplam} = T_{başlangıç} + n \cdot T_{çalışma}\]Başlangıçta JIT maliyeti yüksek olabilir; ancak çağrı sayısı $n$ büyüdükçe optimize edilmiş T_{çalışma} toplam süreyi avantajlı hâle getirir.
Neden bu mimari önemlidir?
Bytecode ve VM yaklaşımı, “bir kere derle, her yerde çalıştır” vaadinin temelidir. Java’nın JVM’i, .NET’in CLR’ı, Python’ın CPython VM’i ve JavaScript motorları bu fikrin farklı uygulamalarıdır. Elbette her biri aynı şekilde çalışmaz: bazıları stack tabanlı, bazıları register tabanlıdır; bazıları agresif JIT kullanır.
Bir geliştirici için bu katmanları bilmek performans sorunlarını daha doğru yorumlamayı sağlar. Yavaşlığın kaynağı algoritma mı, yorumlama maliyeti mi, çöp toplayıcı mı, yoksa JIT’in henüz devreye girmemesi mi? Bytecode yolculuğunu anlayınca, kodunuzun yalnızca yazdığınız satırlardan ibaret olmadığını; donanıma ulaşana kadar akıllı bir tercüman ekibinden geçtiğini fark edersiniz.
Yorumlar