İçindekiler
İnsan genomu yaklaşık 3 milyar nükleotitten oluşur. Bu devasa metin içinde tek bir harfin değişmesi, eklenmesi veya silinmesi bile biyolojik açıdan önemli bir mutasyonu gösterebilir. Ancak DNA dizilerini sıradan metinler gibi karşılaştırmak yeterli değildir; evrimsel değişimleri, boşlukları ve hatalı okumaları hesaba katan özel algoritmalara ihtiyaç duyarız. ``
DNA hizalama problemi nedir?
Dizi hizalama, iki DNA dizisindeki benzer bölgeleri bulma işlemidir. DNA alfabesi yalnızca A, C, G ve T harflerinden oluşsa da olası hizalama sayısı diziler uzadıkça patlayıcı biçimde büyür.
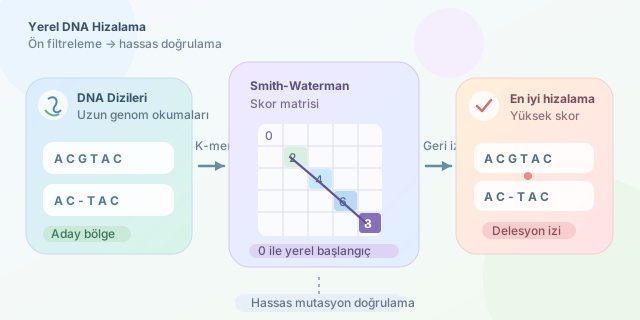
Örneğin şu iki kısa diziye bakalım:
Dizi 1: A C G T A C
Dizi 2: A C - T A C
Aradaki -, ikinci dizide bir silinme veya birinci dizide bir eklenme olabileceğini anlatır. Temel mutasyon türleri şöyledir:
| Mutasyon | Açıklama | Örnek |
|---|---|---|
| Substitüsyon | Bir nükleotidin değişmesi | A → G |
| İnsersiyon | Yeni nükleotid eklenmesi | ACG → ACTG |
| Delesyon | Bir nükleotidin silinmesi | ACGT → AGT |
Smith-Waterman nasıl çalışır?
Smith-Waterman, iki dizinin tamamını değil, en iyi eşleşen yerel bölgelerini bulur. Bu özellik, uzun bir genom içindeki kısa bir gen parçasını veya mutasyonlu okuma dizisini ararken oldukça değerlidir.
Algoritma dinamik programlama kullanır. Uzunlukları $m$ ve $n$ olan diziler için $(m+1) \times (n+1)$ boyutunda bir skor matrisi oluşturulur. Her hücrenin değeri şu mantıkla hesaplanır:
\[H_{i,j} = \max(0, H_{i-1,j-1}+s, H_{i-1,j}-g, H_{i,j-1}-g)\]Burada $s$, eşleşme veya uyumsuzluk skoru; $g$ ise boşluk cezasıdır. Sıfırın seçeneklere eklenmesi kritiktir: skor kötüleştiğinde hizalama kesilir ve yeni bir yerel eşleşme başlatılır.
| Durum | Örnek skor | Anlamı |
|---|---|---|
| Eşleşme | +2 |
Aynı nükleotid |
| Uyumsuzluk | -1 |
Olası substitüsyon |
| Boşluk | -2 |
Ekleme veya silme |
| Sıfır | 0 |
Yerel hizalamayı yeniden başlat |
Basitleştirilmiş Python uygulaması
Aşağıdaki kod, en yüksek yerel hizalama skorunu hesaplar:
def smith_waterman(seq1, seq2, match=2, mismatch=-1, gap=-2):
    rows, cols = len(seq1) + 1, len(seq2) + 1
    matrix = [[0] * cols for _ in range(rows)]
    best_score = 0
    best_position = (0, 0)

    for i in range(1, rows):
        for j in range(1, cols):
            score = match if seq1[i - 1] == seq2[j - 1] else mismatch

            diagonal = matrix[i - 1][j - 1] + score
            deletion = matrix[i - 1][j] + gap
            insertion = matrix[i][j - 1] + gap

            matrix[i][j] = max(0, diagonal, deletion, insertion)

            if matrix[i][j] > best_score:
                best_score = matrix[i][j]
                best_position = (i, j)

    return best_score, best_position

score, position = smith_waterman("ACGTAC", "ACTAC")
print(score, position)
Matris doldurulurken çapraz hareket eşleşme veya substitüsyonu, yukarı ve sola hareketler ise boşlukları temsil eder. En yüksek skorlu hücre bulunduğunda geriye izleme yapılarak gerçek hizalama çıkarılabilir.
Milyarlarca nükleotitte hız sorunu
Smith-Waterman kesin sonuç verir fakat zaman karmaşıklığı $O(mn)$, bellek ihtiyacı da klasik biçiminde $O(mn)$ olur. Milyarlarca baz üzerinde her hücreyi hesaplamak pratik değildir. Bu yüzden gerçek sistemler önce aday bölgeleri bulur, ardından pahalı hizalamayı yalnızca bu bölgelere uygular.
| Teknik | Sağladığı avantaj |
|---|---|
| K-mer indeksleme | Kısa ortak parçaları hızla bulur |
| Bantlı hizalama | Matrisin yalnızca olası bölümünü hesaplar |
| SIMD | Birden çok hücreyi paralel işler |
| GPU hızlandırma | Binlerce hizalamayı eş zamanlı yürütür |
| Sezgisel filtreleme | Zayıf adayları erkenden eler |
BLAST gibi araçlar hız için sezgisel yöntemlerden yararlanırken Smith-Waterman doğruluğun önemli olduğu son doğrulama aşamasında öne çıkar. Modern biyoinformatik iş akışının sırrı, tüm samanlığı tek tek taramak değil; önce güçlü adayları seçip mutasyon iğnesini hassas bir hizalamayla doğrulamaktır.
Yorumlar