Bir servis diğerine veri gönderirken çoğu geliştiricinin ilk tercihi JSON olur: okunabilir, hata ayıklaması kolay ve her dilde desteklenir. Ancak milyonlarca mesajın dolaştığı sistemlerde { "id": 42 } gibi metinler beklenmedik bir maliyete dönüşür. Binary serialization, veriyi karakter dizileri yerine baytlar olarak temsil ederek ağ trafiğini, bellek kullanımını ve ayrıştırma süresini azaltmayı hedefler. Özellikle mikroservisler, oyun sunucuları, IoT cihazları ve olay akışı sistemlerinde önemli bir performans aracıdır.
``
Temel fikir oldukça basittir: Metinsel biçimde 12345 değeri beş ASCII karakteriyle taşınabilir; ikili biçimde ise uygun veri tipine göre sabit uzunluklu veya değişken uzunluklu birkaç baytla ifade edilebilir. Bir mesajın toplam boyutunu kabaca şöyle düşünebiliriz:
JSON’da alan adları, tırnaklar, virgüller ve parantezler de ağdan geçer. İkili protokoller çoğunlukla alanları sayısal kimliklerle tanımlar; böylece tekrar eden metin anahtarları ortadan kalkar. Örneğin user_id yerine şemada tanımlanmış 1 numaralı alan kullanılabilir.
| Özellik | JSON | Binary Serialization |
|---|---|---|
| İnsan tarafından okunabilirlik | Çok yüksek | Düşük |
| Mesaj boyutu | Genellikle daha büyük | Genellikle daha küçük |
| Şema ihtiyacı | Opsiyonel | Sıkça gerekli |
| Hata ayıklama | Tarayıcıyla bile kolay | Araç veya decoder gerekir |
| Dil uyumluluğu | Çok geniş | Kütüphaneye bağlı ama güçlü |
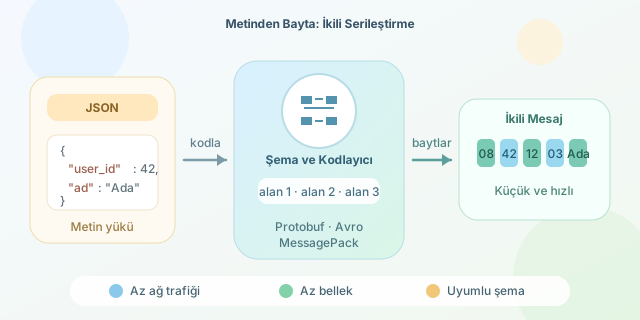
Binary dünyasında tek bir standart yoktur. Protocol Buffers (Protobuf), Google tarafından geliştirilen ve şema odaklı popüler bir çözümdür. Apache Avro, özellikle veri akışları ve şema evrimi için güçlüdür. MessagePack ise JSON’a benzer veri modelini daha kompakt baytlara dönüştürür; hızlı başlamak isteyen ekipler için pratiktir. FlatBuffers ve Cap’n Proto gibi araçlar ise bazı senaryolarda veriyi kopyalamadan okumaya odaklanır.
Protobuf kullanımında önce veri sözleşmesini yazarsınız. Bu sözleşme, istemci ile sunucunun aynı mesajı aynı şekilde yorumlamasını sağlar:
syntax = "proto3";

message User {
  uint64 id = 1;
  string name = 2;
  repeated string roles = 3;
}
Buradaki = 1, = 2 ve = 3 değerleri yalnızca sıralama değildir; kablodan geçen alan etiketleridir. Kod üretici araç, bu dosyadan Python, Go, Java veya TypeScript sınıfları oluşturur. Ardından mesajı serileştirmek oldukça doğaldır:
user = User(id=42, name="Ada", roles=["admin", "editor"])
payload = user.SerializeToString()

restored = User()
restored.ParseFromString(payload)
print(restored.name)  # Ada
Bu örnekte SerializeToString() nesneyi bayt dizisine çevirir; ParseFromString() ise ters işlemi yapar. Ancak küçük mesaj her zaman otomatik olarak daha hızlı sistem demek değildir. Serileştirme CPU harcar, şema araç zinciri getirir ve loglarda ham baytları incelemek JSON kadar rahat değildir. Performans kararı ölçümle verilmelidir:
Şema evrimi binary serialization’ın kritik noktasıdır. Bir alanı kaldırmak yerine numarasını rezerve etmek, yeni alanları yeni numaralarla eklemek ve eski istemcilerin bilmediği alanları güvenle atlayabilmesini sağlamak gerekir. Alan numarasını değiştirmek ise çoğu zaman geriye uyumluluğu bozar.
| Senaryo | Uygun tercih | Neden |
|---|---|---|
| Genel amaçlı REST API | JSON | Kolay inceleme ve yaygın destek |
| gRPC mikroservisleri | Protobuf | Sıkı sözleşme, küçük mesajlar |
| Kafka veri akışları | Avro | Şema evrimi ve ekosistem |
| Hızlı JSON alternatifi | MessagePack | Benzer model, daha az bayt |
Sonuç olarak binary serialization, JSON’un düşmanı değil, ölçek büyüdüğünde devreye giren uzman aracıdır. İnsanların okuyacağı entegrasyonlarda JSON harikadır; makinelerin saniyede on binlerce mesaj taşıdığı hatlarda ise ikili biçimler ciddi fark yaratabilir. En iyi başlangıç, gerçek üretim trafiğine yakın bir benchmark hazırlamak ve boyut, gecikme, CPU ile geliştirici deneyimini birlikte ölçmektir.
Yorumlar