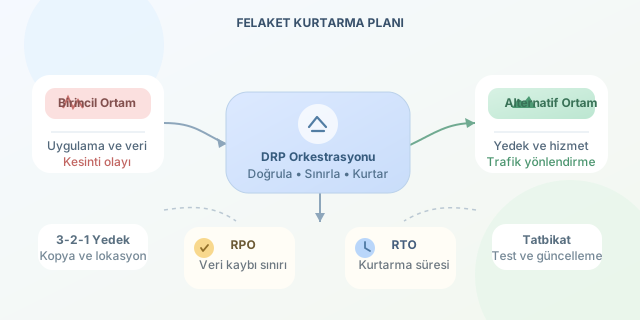
Sunucu odasını su bastığını, kritik verilerin yanlışlıkla silindiğini veya fidye yazılımının tüm sistemleri şifrelediğini düşünün. Böyle bir anda “Yedeğimiz vardı galiba” cümlesi pek güven vermez. Felaket Kurtarma Planı, yani Disaster Recovery Plan (DRP), bilişim sistemlerini önceden belirlenen süre ve veri kaybı sınırları içerisinde alternatif bir ortamda yeniden çalıştırmak için hazırlanan teknik ve operasyonel yol haritasıdır.
``
DRP tam olarak neyi çözer?
DRP; fiziksel donanım kaybı, depolama arızası, veri silinmesi, siber saldırı, elektrik kesintisi ve doğal afet gibi olaylardan sonra sistemlerin ayağa kaldırılmasına odaklanır. İş sürekliliği planı tüm organizasyonun çalışmasını kapsarken DRP, ağırlıklı olarak bilgi teknolojileri altyapısını ele alır.
Planın temelinde iki önemli hedef bulunur:
- RTO (Recovery Time Objective): Bir sistemin en fazla ne kadar süre kapalı kalabileceğidir.
- RPO (Recovery Point Objective): Geri dönüş sırasında kabul edilebilecek en yüksek veri kaybı süresidir.
Örneğin son yedek saat 12.00’de alınmış, felaket 12.15’te gerçekleşmişse olası veri kaybı 15 dakikadır. Basitleştirilmiş biçimde:
\[RPO = T_{felaket} - T_{son\_kurtarılabilir\_veri}\]Bir e-ticaret sistemi için 5 dakikalık RPO gerekli olabilirken, aylık rapor arşivi için 24 saat kabul edilebilir. Daha düşük RTO ve RPO değerleri daha güçlü altyapı gerektirir; bunun doğal sonucu daha yüksek maliyettir.
| Yaklaşım | Tahmini RTO | Maliyet | Kullanım durumu |
|---|---|---|---|
| Yedekten geri yükleme | Saatler/günler | Düşük | Kritik olmayan sistemler |
| Soğuk lokasyon | Günler | Düşük-Orta | Donanım sonradan kurulur |
| Ilık lokasyon | Saatler | Orta | Altyapı hazır, veri eşitlenir |
| Sıcak lokasyon | Dakikalar | Yüksek | Kritik ve kesintisiz hizmetler |
| Aktif-aktif mimari | Saniyeler | Çok yüksek | Finans, telekom, büyük platformlar |
Sağlam bir planın bileşenleri
İlk adım, sistem envanteri çıkarmaktır. Sunucular, veritabanları, uygulamalar, DNS kayıtları, sertifikalar, harici servisler ve sorumlular belgelenmelidir. Ardından iş etki analizi yapılarak sistemler önem derecesine göre sıralanır. Çünkü felaket anında yemek menüsü uygulamasını ödeme sisteminden önce açmak, teknik açıdan başarılı fakat ticari açıdan trajikomik olabilir.
Yedekler 3-2-1 kuralına göre tasarlanabilir: Verinin üç kopyası, iki farklı ortam ve bir farklı lokasyon. Fidye yazılımlarına karşı çevrimdışı veya değiştirilemez yedek kullanılması da önemlidir. Yalnızca yedek almak yeterli değildir; yedeğin gerçekten geri yüklenebildiği doğrulanmalıdır.
Basit bir Linux yedekleme ve doğrulama örneği şöyledir:
#!/bin/bash
DATE=$(date +%F)
ARCHIVE="app-$DATE.tar.gz"

# Uygulama verilerini sıkıştırır.
tar -czf "/backup/$ARCHIVE" /opt/application/data

# Dosyanın bütünlük kontrolü için özet üretir.
sha256sum "/backup/$ARCHIVE" > "/backup/$ARCHIVE.sha256"

# Yedeği uzak felaket kurtarma lokasyonuna gönderir.
rsync -av "/backup/$ARCHIVE"* dr-site:/immutable-backups/
Bu betik başlangıç sağlar ancak erişim anahtarlarının korunması, şifreleme, saklama süresi, hata bildirimleri ve otomatik geri yükleme testleri ayrıca planlanmalıdır.
Felaket anındaki sıra
DRP içerisinde olayın kim tarafından ilan edileceği açıkça yazılmalıdır. Genel akış; olayın doğrulanması, ekiplerin bilgilendirilmesi, hasarın sınırlandırılması, alternatif lokasyonun etkinleştirilmesi, verilerin yüklenmesi, uygulama testleri ve trafiğin yeni ortama yönlendirilmesi şeklindedir. Her adımın sahibi ve azami tamamlanma süresi bulunmalıdır.
Plan yılda en az bir kez masa başı tatbikatı ve teknik kurtarma testiyle sınanmalıdır. Altyapı değiştikçe belge de güncellenmelidir. Test edilmemiş bir DRP, teoride paraşüt taşımaya benzer: Çantanın içinde gerçekten paraşüt olup olmadığını ihtiyaç anında öğrenmek istemezsiniz. Başarılı felaket kurtarma; teknoloji, dokümantasyon, eğitimli ekip ve düzenli tatbikatın birlikte çalışmasıyla mümkündür.
Yorumlar