İçindekiler
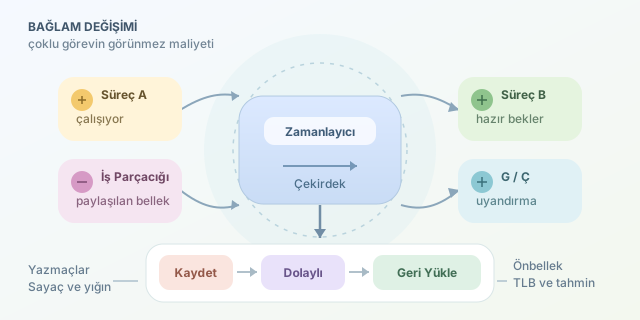
Bilgisayarınız müzik çalarken kod derliyor, bildirim gösteriyor ve onlarca tarayıcı sekmesini canlı tutuyor. İşlemci çekirdeği gerçekte aynı anda yalnızca sınırlı sayıda işi yürütür; işletim sistemi süreçleri hızla sıraya koyarak eşzamanlılık yanılsaması oluşturur. Bir süreçten diğerine geçiş ise ücretsiz değildir. Halk arasında “saniyelik duraklama” denilse de modern sistemlerde tek bir bağlam değişimi çoğunlukla nanosaniye veya mikrosaniye ölçeğindedir. Asıl sorun, bu küçük maliyetin saniyede binlerce kez tekrarlanmasıdır.
``
Bağlam değişiminde ne saklanır?
İşletim sistemi, çalışan süreci durdurduğunda daha sonra aynı noktadan devam edebilmesi için işlemci durumunu süreç kontrol bloğuna kaydeder. Ardından seçilen sürecin durumu geri yüklenir. Saklanan bilgiler genellikle şunlardır:
- Program sayacı ve yığın işaretçisi
- Genel amaçlı işlemci yazmaçları
- İşlem zamanlama ve durum bilgileri
- Bellek yönetimiyle ilişkili sayfa tablosu bilgileri
- Gerektiğinde kayan nokta ve SIMD yazmaçları
Basitleştirilmiş toplam maliyet şöyle modellenebilir:
\[C_{toplam} = C_{kaydet} + C_{zamanlayıcı} + C_{yükle} + C_{dolaylı}\]İlk üç terim işletim sisteminin yaptığı görünür çalışmadır. $C_{dolaylı}$ ise önbelleklerin, TLB’nin ve işlemci tahmin mekanizmalarının yeni sürece uyum sağlama maliyetidir. Çoğu zaman performansı asıl sarsan bölüm budur.
Doğrudan ve dolaylı maliyetler
| Maliyet | Kaynak | Olası sonuç |
|---|---|---|
| Doğrudan | Yazmaçları kaydetme ve yükleme | İşlemci yararlı iş yapamaz |
| Zamanlayıcı | Sıradaki görevi seçme | Yoğun sistemlerde gecikme artar |
| Önbellek | Yeni sürecin verilerini getirme | Cache miss oluşur |
| TLB | Sanal-fiziksel adres eşleşmelerini yenileme | Bellek erişimi yavaşlar |
| Dal tahmini | Farklı kod akışına geçme | İşlem hattı temizlenebilir |
Aynı sürecin iki iş parçacığı arasındaki geçiş, farklı süreçler arasındaki geçişten genellikle daha ucuzdur. İş parçacıkları adres alanını paylaşabildiği için bellek bağlamı daha az değişir. Yine de kilit çekişmesi ve çekirdekler arası veri taşıma bu avantajı tersine çevirebilir.
Maliyet nasıl ölçülür?
Yaygın yöntemlerden biri, iki süreç arasında pipe üzerinden küçük bir veriyi defalarca gönderip toplam süreyi ölçmektir. Her gidiş-dönüş yaklaşık iki bağlam değişimi oluşturur:
#include <time.h>
#include <unistd.h>
#include <stdio.h>

int main(void) {
    int a[2], b[2], n = 100000;
    char token = 'x';
    pipe(a); pipe(b);

    if (fork() == 0) {
        for (int i = 0; i < n; i++) {
            read(a[0], &token, 1);
            write(b[1], &token, 1);
        }
        return 0;
    }

    struct timespec start, end;
    clock_gettime(CLOCK_MONOTONIC, &start);
    for (int i = 0; i < n; i++) {
        write(a[1], &token, 1);
        read(b[0], &token, 1);
    }
    clock_gettime(CLOCK_MONOTONIC, &end);

    double ns = (end.tv_sec - start.tv_sec) * 1e9
              + (end.tv_nsec - start.tv_nsec);
    printf("Yaklaşık geçiş maliyeti: %.1f ns\n", ns / (2 * n));
}
Kod iki süreç arasında bir baytlık “pinpon” oynatır. Ancak sonuç yalnızca bağlam değişimini değil, sistem çağrısı ve pipe iletişimi maliyetlerini de içerir. Daha güvenilir deneyler için süreçleri aynı çekirdeğe sabitlemek, sistemi boşta tutmak, ısınma turları çalıştırmak ve ölçümü birkaç kez tekrarlamak gerekir.
Ne zaman performans sorununa dönüşür?
Saniyedeki değişim sayısı $N$, ortalama maliyet de $C$ ise harcanan süre yaklaşık olarak:
\[T_{kayıp} = N \times C\]Örneğin 5 mikrosaniyelik 100.000 geçiş, teorik olarak yarım saniyelik işlemci zamanı tüketebilir. Çok fazla iş parçacığı oluşturmak, kısa görevleri sürekli uyandırmak, yoğun kilit kullanmak ve aşırı G/Ç beklemesi bu sayıyı yükseltir.
Çözüm her zaman “daha az süreç” değildir. İş parçacığı havuzları, olay tabanlı mimariler, görevleri toplu işleme ve uygun zaman dilimleri geçiş sayısını azaltabilir. Linux üzerinde perf stat, vmstat ve /proc verileri gönüllü ya da zorunlu bağlam değişimlerini izlemek için kullanılabilir. Sonuçta bağlam değişimi çoklu görevin görünmez hizmet bedelidir: Tek başına küçüktür, fakat kontrolsüz tekrarlandığında işlemci bütçesini sessizce yiyebilir.
Yorumlar